· Nacho Planas
La aventura de la cadena de suministro de la IA: cómo los minerales se convierten en LLMs
Cada respuesta que te da un chatbot ha pasado por una mina de cuarzo, una fuente de luz holandesa, una línea de encapsulado taiwanesa, una pila de memoria coreana, una columna de cobre, una turbina de gas y un entrenamiento que costó más de lo que valen la mayoría de las empresas. Aquí está la cadena completa, trece capas de profundidad, con las compañías que controlan cada una y lo que las hace difíciles de sustituir.
Aviso: No es asesoramiento de inversión. Es un ensayo sobre cómo encaja una industria. Las cifras son las publicadas por empresas, gobiernos y firmas de análisis hasta el 26 de septiembre de 2026. Cuando un dato es una estimación de analistas, lo digo.
Una respuesta, trece industrias
Le haces una pregunta a un chatbot y la respuesta parece salir de la nada. En realidad sale de una de las cadenas de suministro más largas que ha construido el ser humano. Antes de que esas palabras llegaran a tu pantalla, alguien extrajo cuarzo en Carolina del Norte y cobre en Chile, una química alemana purificó silicio hasta once nueves, una máquina holandesa disparó cincuenta mil gotas de estaño fundido por segundo, una fábrica taiwanesa montó dos chips y ocho torres de memoria en un solo encapsulado, una empresa coreana adelgazó DRAM hasta el grosor de un pelo y la apiló en doce capas, y un centro de datos en Texas quemó gas natural para alimentar un rack que pesa tanto como un coche y consume tanta electricidad como cien hogares.
Después, un modelo entrenado durante meses con decenas de billones de palabras leyó tu pregunta en una fracción de segundo y escribió la respuesta token a token.
Este ensayo sigue ese viaje de principio a fin: cómo un puñado de minerales se convierte en un gran modelo de lenguaje. Eso significa cada capa desde el suelo hacia arriba, qué ocurre físicamente en cada una, qué empresas la controlan y qué las hace difíciles de sustituir. Es largo, porque el viaje es largo. Primero, el mapa.
Conviene saber unas cuantas cosas antes de empezar.
- La cadena no es una línea, es un embudo. Miles de proveedores en la base se estrechan hasta un puñado de cuellos de botella en el centro (una sola empresa fabrica las máquinas de litografía, una sola fundición fabrica casi todos los aceleradores, tres empresas fabrican toda la memoria de alto ancho de banda) y luego se vuelven a abrir en miles de edificios y millones de aplicaciones.
- La restricción que manda va cambiando de sitio. En 2023 fue el encapsulado; en 2024, la memoria; en 2025, la electricidad y las turbinas; en 2026, otra vez la memoria, además de los láseres y las CPU. Quien controla el cuello de botella del momento tiene poder de fijación de precios durante un tiempo.
- Todo crece, pero no al mismo ritmo. Al final pongo lado a lado las tasas de crecimiento de cada capa.
Capa 1: el suelo
El silicio empieza siendo cuarzo, y la pureza se mide en nueves
El silicio es el segundo elemento más abundante de la corteza terrestre, así que su escasez no está en los átomos. Está en la pureza.
El proceso empieza con cuarzo (dióxido de silicio) y carbono en un horno de arco eléctrico, que produce silicio de grado metalúrgico con una pureza de alrededor del 99%. China fabricó 4 millones de toneladas en 2025, cerca del 80% de la oferta mundial, según el Servicio Geológico de Estados Unidos (USGS). La mayor parte se destina a aleaciones de aluminio y siliconas. Según una estimación del Gobierno estadounidense, solo alrededor del 12% se convierte en polisilicio, y casi todo ese polisilicio acaba en paneles solares.
El polisilicio a partir del cual se crecen los chips es de otra naturaleza. Tiene que tener como mínimo once nueves de pureza: 99,999999999%, más o menos un átomo extraño por cada cien mil millones. El polisilicio de grado solar está entre seis y diez nueves. Según el escrito que la Semiconductor Industry Association (SIA) remitió en 2025 al Departamento de Comercio de EE. UU. (con datos de TECHCET), el material de grado semiconductor es apenas el 2,4% de la demanda mundial de polisilicio: unas 33.500 toneladas frente a 1,38 millones de toneladas de grado solar. Fabricarlo puede costar hasta treinta veces más. China tiene el 94,7% de la capacidad mundial de polisilicio, pero casi toda es de grado solar; la SIA sostiene que a China le faltan los equipos y el saber hacer para producir el grado de chip a escala.
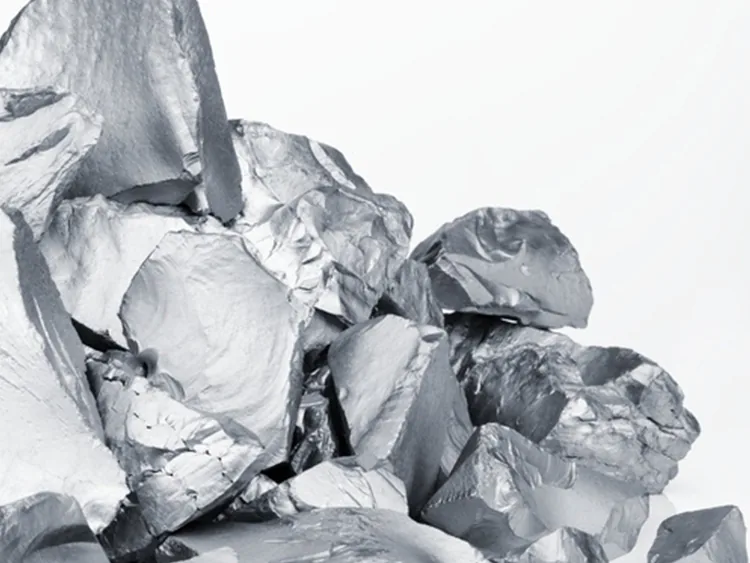
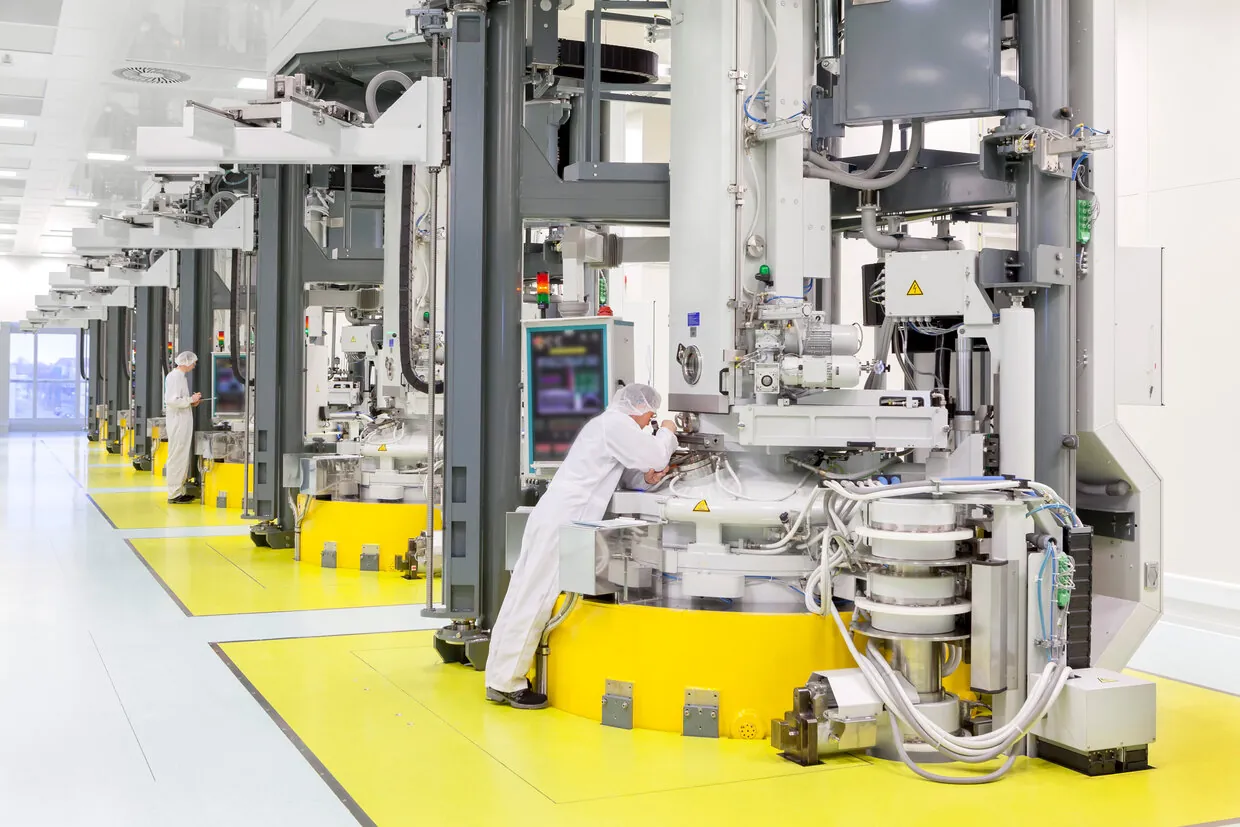
Dos empresas, Wacker Chemie en Alemania y Hemlock Semiconductor en Michigan, suministran alrededor de tres cuartas partes del polisilicio de grado chip. Tokuyama, SUMCO y OCI fabrican la mayor parte del resto. El polisilicio se funde y de la masa fundida se extrae lentamente un cristal semilla (el método Czochralski), que crece hasta formar un lingote monocristalino de unos siete pies de largo (unos dos metros) y unas 600 libras de peso (unos 270 kilos). Se corta en obleas de 300 mm, se pule hasta quedar más plano que casi cualquier otra cosa que fabrique el ser humano y se envía a las fábricas.
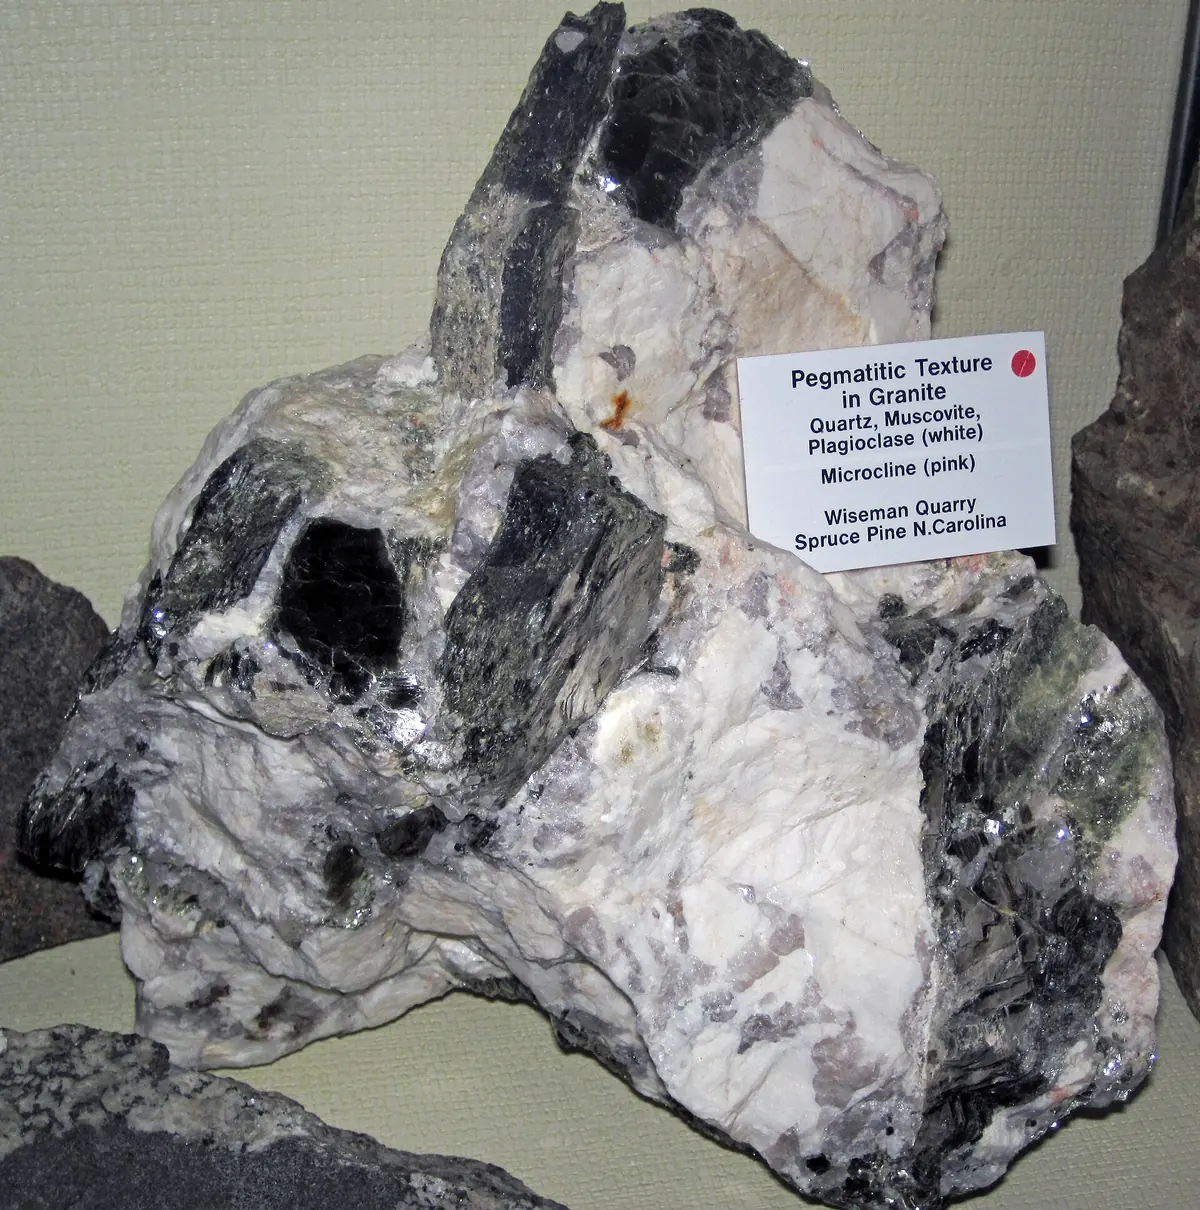
La masa fundida reposa en un crisol de cuarzo, y aquí es donde importa un pueblecito de los montes Blue Ridge. Spruce Pine, en Carolina del Norte, tiene yacimientos de cuarzo excepcionalmente puros, explotados por Sibelco y The Quartz Corp, de los que la industria depende desde hace décadas para fabricar crisoles. Cuando el huracán Helene inundó la zona en septiembre de 2024, ambas explotaciones se pararon. Sibelco reanudó la actividad el 10 de octubre y fue recuperando el ritmo. Los daños resultaron manejables, pero durante dos semanas el mundo descubrió cuánto dependía de un solo valle. Se suele decir que Spruce Pine suministra entre el 70% y el 90% del cuarzo de ultraalta pureza del mundo. No he encontrado una fuente primaria para esa cifra, pero nadie discute que es la principal.
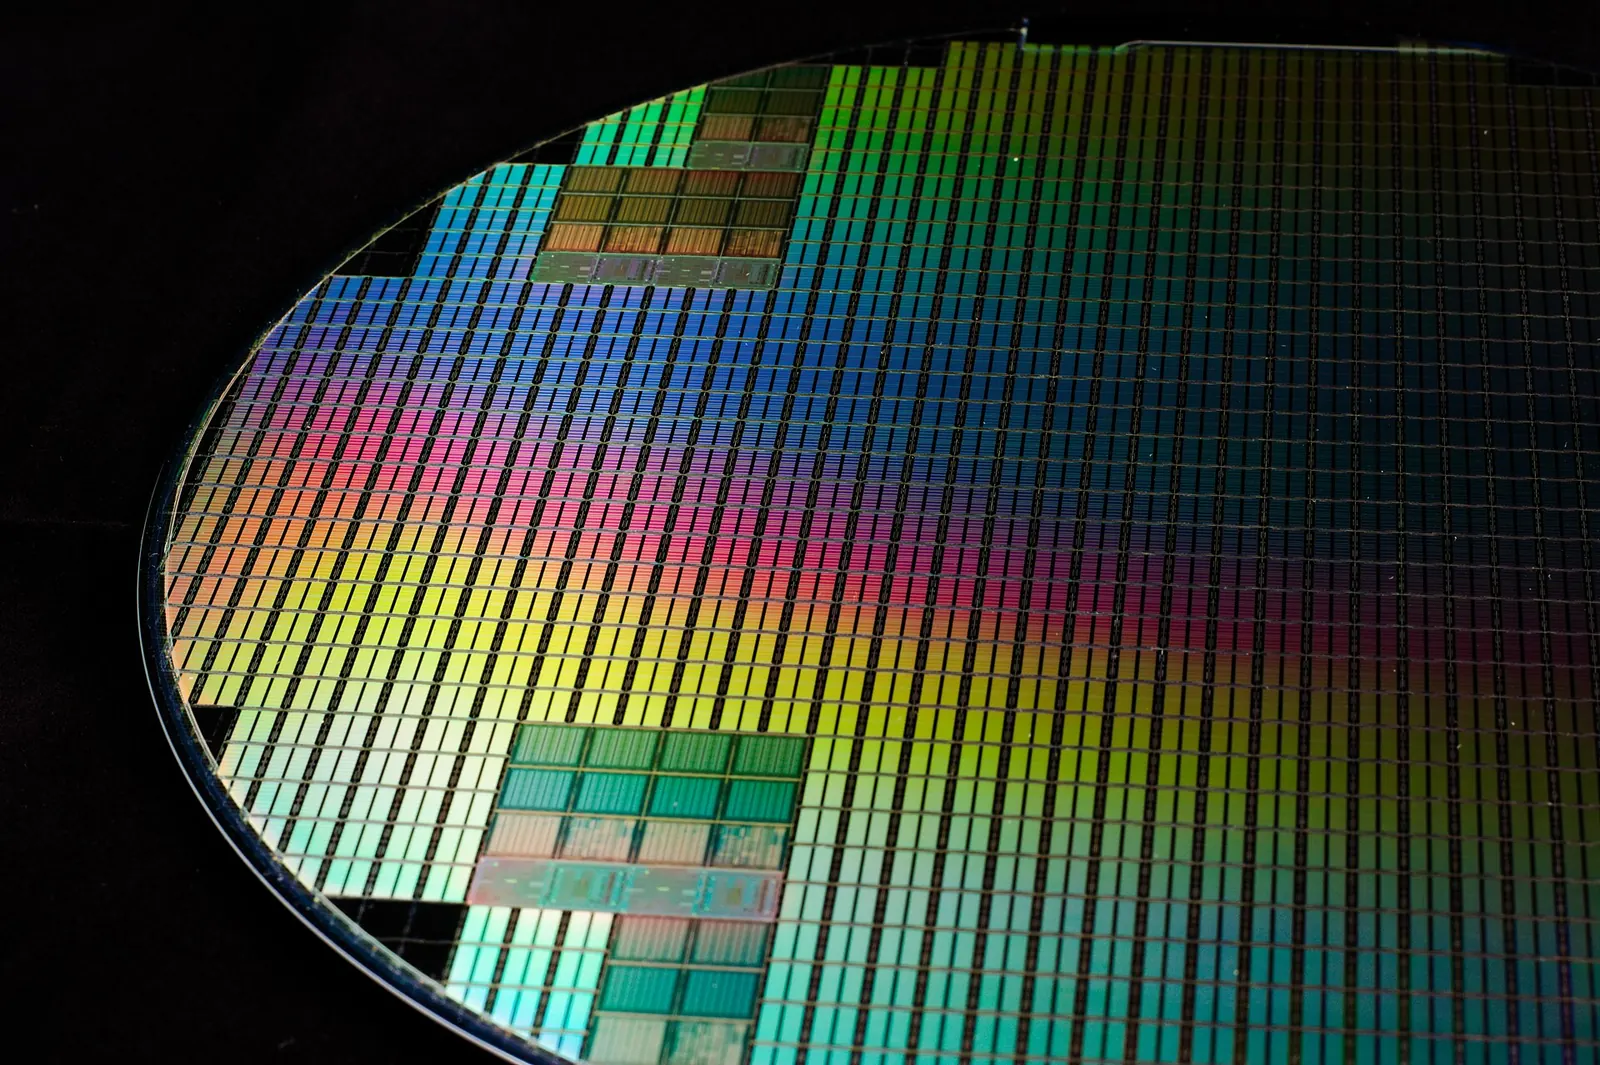
Las obleas son un negocio concentrado en sí mismo. Shin-Etsu y SUMCO, ambas japonesas, suministran aproximadamente la mitad de las obleas de 300 mm del mundo según estimaciones de firmas de estudios de mercado; GlobalWafers (Taiwán), Siltronic (Alemania) y SK Siltron (Corea) fabrican la mayor parte del resto. SEMI contabiliza 12.973 millones de pulgadas cuadradas enviadas en 2025, un 5,8% más, con la demanda de obleas de lógica y HBM para IA tirando del carro.
Un dato útil para más adelante: una oblea de 300 mm da unos 60 candidatos a chip de GPU al tamaño máximo que una máquina de litografía puede imprimir. Descontando defectos, quizá 40 o 50 salen buenos, y una GPU Blackwell necesita dos. Así que una oblea que cuesta unos 20.000–30.000 dólares procesar en un nodo de vanguardia se convierte en entre veinte y treinta GPU que se venden a decenas de miles de dólares cada una. Es una estimación propia a partir de la fórmula estándar de chips por oblea, no un dato de ninguna empresa, pero explica por qué TSMC puede cobrar lo que cobra.
Los minerales que no son silicio
Un chip, y el centro de datos en el que está, necesita una larga lista de otros elementos. El galio va en chips de radiofrecuencia y en algunos láseres. El germanio, en fibra óptica y en óptica infrarroja. El indio, en forma de fosfuro de indio, es el material que convierte las señales eléctricas en luz láser en todos los transceptores ópticos. El wolframio forma los contactos y tapones que conectan un transistor con su cableado. La fluorita se convierte en la química del flúor que se usa para grabar y limpiar las obleas. Las tierras raras van en los imanes de ventiladores, bombas, motores y turbinas. Y el cobre va en casi todo: barras colectoras, cables, transformadores y motores.
En toda esa lista, China es el refinador dominante.
China produjo el 99% del galio primario del mundo en 2025, extrajo el 79% de su wolframio y el 82% de su grafito natural, y refina el 69% de su indio. Su cuota de la capacidad de fundición de cobre ha pasado de alrededor del 15% al 50%, según las perspectivas de minerales críticos de la AIE para 2026, que también concluyen que la cuota media de los tres mayores refinadores en los minerales clave subió al 86% en 2024.
China ha hecho uso de esa posición. En diciembre de 2024 prohibió las exportaciones de galio, germanio y antimonio a EE. UU. En febrero de 2025 añadió el wolframio, el indio y otros a su régimen de licencias; las obleas de fosfuro de indio necesitan un permiso, y por eso AXT, un proveedor cotizado en EE. UU. con sus fábricas en China, cita los permisos como riesgo para el negocio aunque sus ingresos se han más que duplicado. En octubre de 2025 China anunció controles de gran alcance sobre las tierras raras. Luego llegó una tregua. En noviembre de 2025 China suspendió la prohibición sobre el galio, el germanio y el antimonio hasta el 27 de noviembre de 2026 (las licencias siguen siendo obligatorias) y dejó en pausa las normas de octubre sobre tierras raras. En la cumbre entre Trump y Xi en Washington del 24 y 25 de septiembre de 2026, la tregua comercial se prorrogó otros dos meses, hasta el 10 de enero de 2027. Nada de esto se ha resuelto; solo se ha aplazado.
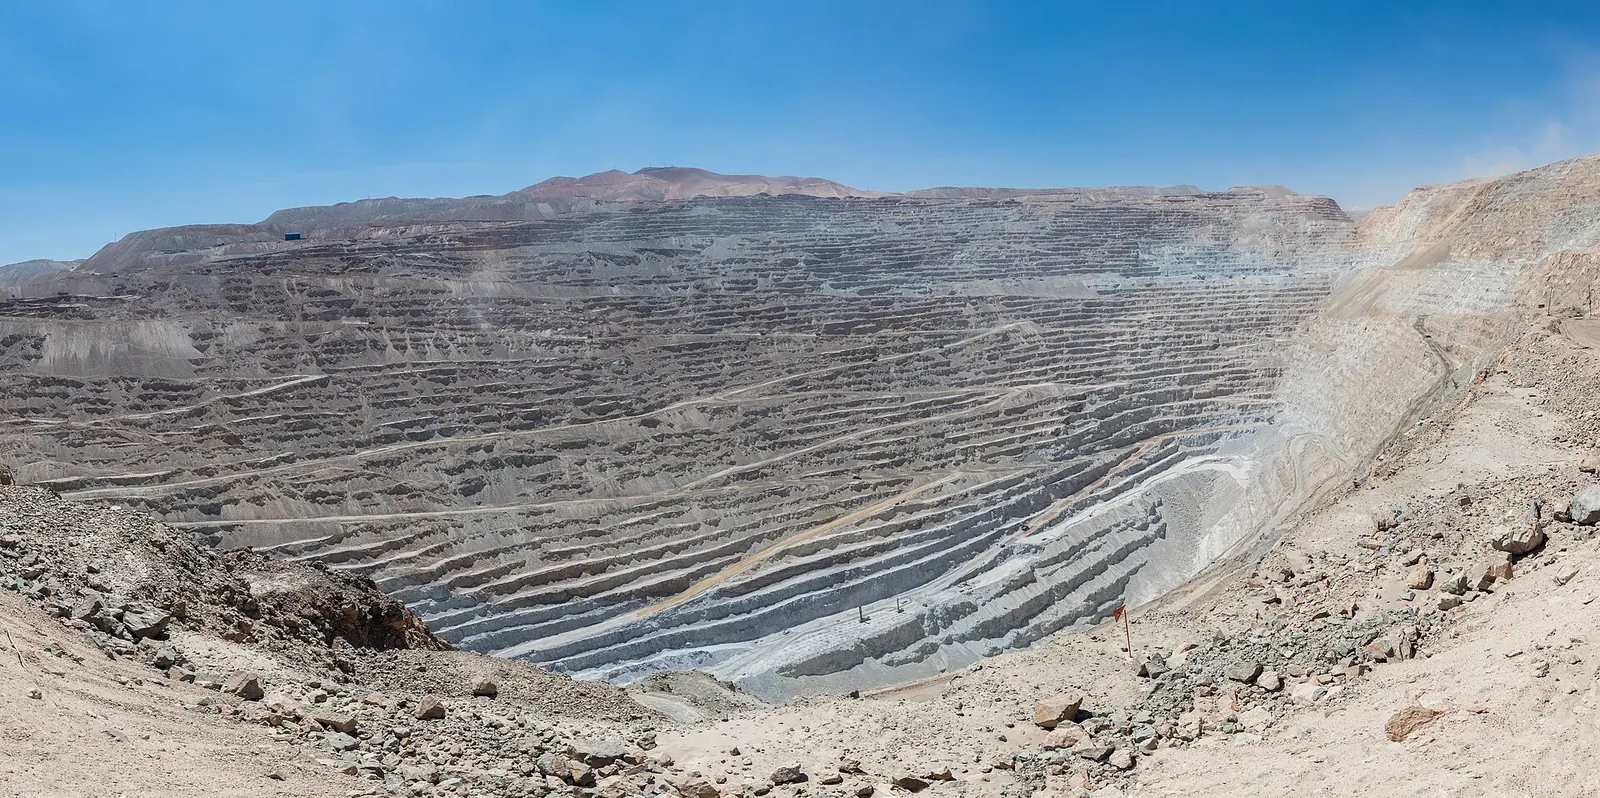
El cobre merece una línea aparte, porque la IA lo consume a granel. Los propios ingenieros de NVIDIA escribieron en 2025 que un rack de un megavatio alimentado a 54 voltios necesita hasta 200 kg de barra colectora de cobre, lo que supone unas 200 toneladas para un emplazamiento de un gigavatio solo en barras colectoras. Y eso antes de cables, transformadores y generadores. El cobre marcó un récord de unos 6,80 dólares la libra a principios de septiembre de 2026 y sube alrededor de un 42% en el año. Los mayores productores son Codelco y BHP en Chile y Freeport-McMoRan, cuya mina de Grasberg, en Indonesia, es una de las más grandes del mundo.
Capa 2: los materiales
La siguiente parada del viaje, entre la mina y la fábrica, es una capa de materiales especiales de los que casi nadie fuera del sector ha oído hablar, y sin los que el sector no puede funcionar.
- Las fotorresinas, los recubrimientos fotosensibles sobre los que imprime la litografía, vienen sobre todo de Japón: JSR, Tokyo Ohka Kogyo, Shin-Etsu y Sumitomo Chemical.
- Los gases especiales, como los compuestos de flúor, el neón, el hexafluoruro de wolframio y el nitrógeno ultrapuro, vienen de los grandes grupos de gases industriales como Linde, Air Liquide y Nippon Sanso. Antes de 2022, cerca de la mitad del neón de grado semiconductor procedía de dos empresas ucranianas. Desde entonces el sector ha diversificado.
- La película Ajinomoto build-up film (ABF) es la que sorprende a la gente. Ajinomoto es la empresa japonesa famosa por el glutamato. En los años noventa, sus químicos se dieron cuenta de que las resinas epoxi de su investigación sobre aminoácidos podían convertirse en una película aislante fina. Desde 1999 esa película es la capa que lleva el cableado fino dentro de casi todos los encapsulados de chips de alto rendimiento. Su cuota se sitúa habitualmente por encima del 95%; la empresa no da cifras, pero no existe ningún competidor serio.
- El tejido de vidrio fabricado con un «vidrio T» especial de baja dilatación es el núcleo rígido de esos sustratos de encapsulado. Nittobo, una textil japonesa, es el proveedor dominante, y en 2026 se publicó que Apple, NVIDIA, Google y Amazon competían por su producción.
- Los sustratos propiamente dichos los fabrican Ibiden, Unimicron, Shinko y AT&S. Intel y Absolics, de SKC, desarrollan sustratos con núcleo de vidrio que podrían sustituir a los orgánicos a finales de la década.
Y luego está el vidrio de otro tipo.
Corning y el regreso del negocio de la fibra
Corning inventó la fibra óptica de baja pérdida en 1970. Durante casi los cincuenta años siguientes fue un negocio estable: las operadoras de telecomunicaciones compraban fibra por ciclos. La IA cambió la curva de demanda. Dentro de un centro de datos de IA, miles de GPU tienen que hablar entre sí a la vez, y cada uno de esos enlaces que supera unos pocos metros es luz en vidrio. Corning afirma que los centros de datos de IA generativa necesitan muchas veces más fibra que los tradicionales.
Las cifras se movieron rápido. En su segundo trimestre de 2026, las ventas de Comunicaciones Ópticas de Corning subieron un 32%, hasta 2.070 millones de dólares, y el segmento empresarial, que son sobre todo centros de datos, creció un 65%. La óptica ya supone cerca de la mitad de las ventas de Corning. En enero de 2026 Meta firmó un contrato plurianual de hasta 6.000 millones de dólares para fibra, cable y conectividad, que sirve de ancla para la ampliación de la planta de cable de Corning en Hickory, Carolina del Norte. Amazon también firmó un contrato de varios miles de millones, y NVIDIA anunció una alianza para multiplicar por diez la capacidad de conectividad óptica en EE. UU. El plan «Springboard» de Corning apunta a un ritmo anual de ventas de 20.000 millones de dólares a finales de 2026 y de 40.000 millones en 2030.
Lo que hace singular a Corning es que vende la parte pasiva de la red (el vidrio, los cables, los conectores y los conjuntos preterminados que permiten a un instalador cablear una sala de datos en días) y no la óptica activa que convierte la electricidad en luz. Es un negocio menos vistoso, pero no se queda obsoleto cada dos años. Prysmian, la fabricante italiana de cables, es la otra gran ganadora. En julio de 2026 firmó un contrato a diez años de hasta 5.500 millones de euros para suministrar cable óptico para centros de datos, y trabaja con Relativity Networks en fibra de núcleo hueco, en la que la luz viaja por aire en lugar de por vidrio y llega casi un 50% antes.
Capa 3: el diseño
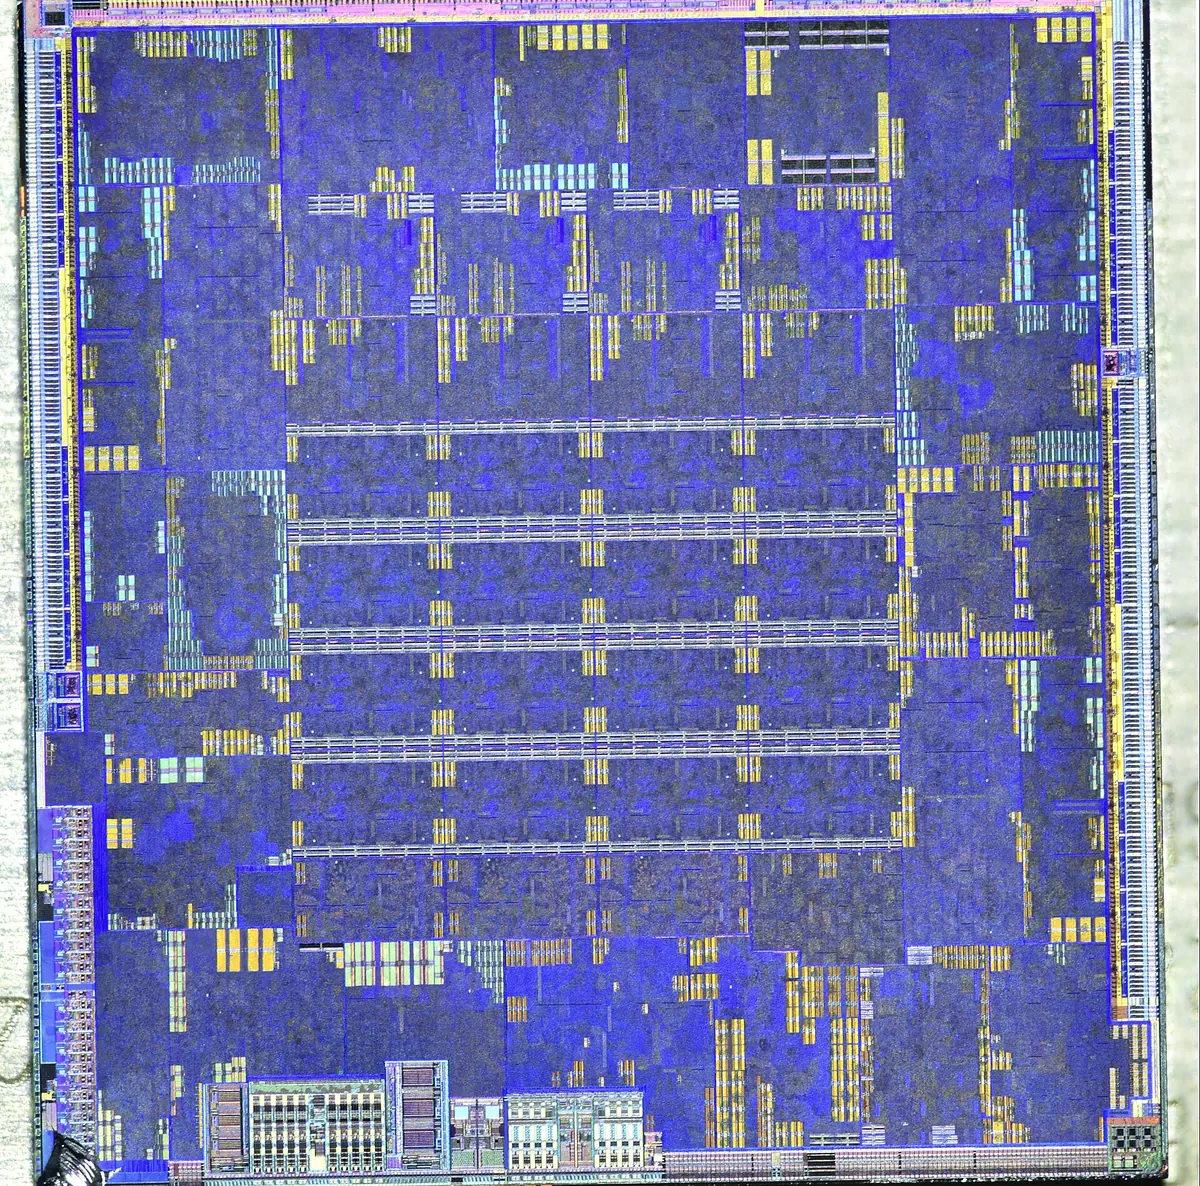
Un acelerador moderno tiene más de cien mil millones de transistores. Nadie los dibuja a mano. Se describen en código, se sintetizan en lógica, se colocan, se enrutan, se simulan y se verifican con software de automatización del diseño electrónico (EDA), y es casi un duopolio.
Synopsys y Cadence tienen cada una cerca del 30% del mercado de EDA, con Siemens EDA (la antigua Mentor Graphics) en torno al 13%, según TrendForce. Synopsys cerró la compra de Ansys en julio de 2025 y sumó la simulación física (calor, tensiones, electromagnetismo) que gana importancia a medida que los chips se apilan en tres dimensiones. La ventaja de Cadence son sus emuladores de hardware, máquinas del tamaño de una habitación que ejecutan el diseño de un chip antes de que exista para poder probar el software meses antes de tener el silicio. NVIDIA tomó una participación de 2.000 millones de dólares en Synopsys en diciembre de 2025 para llevar la aceleración por GPU al flujo de diseño. Todo esto es caro: IBS calcula que diseñar desde cero un chip grande en 2 nm cuesta unos 725 millones de dólares, de los que más de 300 millones son software.
Luego está Arm. No fabrica CPU en el sentido tradicional (o no lo hacía hasta este año). Licencia el conjunto de instrucciones y los diseños de núcleos sobre los que construyen otras empresas. La CPU Grace de NVIDIA usa núcleos Arm Neoverse. También los usan Graviton, de Amazon; Cobalt, de Microsoft, y Axion, de Google. En el trimestre cerrado en junio de 2026, los royalties de Arm por centros de datos se multiplicaron por más de dos en términos interanuales. En marzo de 2026 Arm cruzó una línea que había evitado durante 35 años y lanzó un chip propio, la AGI CPU, fabricada con el proceso de 3 nm de TSMC, con hasta 136 núcleos y Meta como cliente principal. Ahora compite con algunos de sus propios licenciatarios.
El tercer tipo de diseñador es el socio de chips a medida. Google, Amazon, Meta, Microsoft y OpenAI diseñan sus propios aceleradores, pero ninguno hace todo el trabajo solo. Broadcom es el socio dominante: la TPU de Google, la MTIA de Meta y el primer chip de OpenAI, presentado en junio de 2026, pasan todos por ella, y cuenta seis clientes de aceleradores a medida. Marvell hace lo mismo para Amazon y Microsoft, y Alchip y GUC, en Taiwán, se ocupan de la fase física final para otros. El mayor cliente de Alchip (según se entiende, AWS) supuso el 60% de sus ingresos de 2024.
Capa 4: las herramientas
Una fábrica de chips es un edificio lleno de máquinas, y es en las máquinas donde vive la ingeniería más extrema de toda la cadena.
ASML y la luz que no es luz
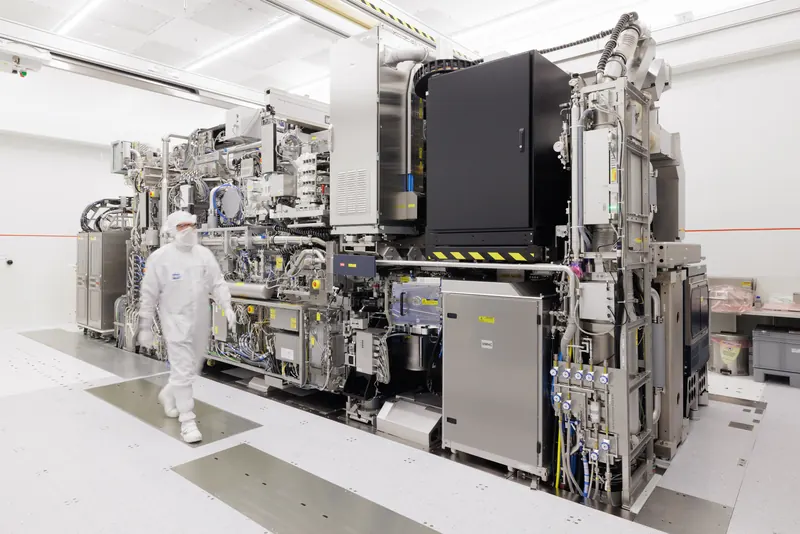
Los chips de vanguardia se imprimen con luz ultravioleta extrema (EUV) con una longitud de onda de 13,5 nanómetros. Ninguna lámpara la produce y ninguna lente puede enfocarla. Así que las máquinas de ASML la fabrican: un generador de gotas dispara 50.000 gotas de estaño fundido por segundo, un láser construido por Trumpf golpea cada gota dos veces, y el segundo pulso la calienta hasta unos 220.000 °C, más que la superficie del Sol, y la convierte en un plasma que brilla a 13,5 nm. La luz la recogen espejos de Zeiss tan lisos que, ampliados al tamaño de Alemania, la mayor irregularidad tendría una décima de milímetro de alto. Todo el sistema funciona en vacío, porque el aire absorbería la luz.
ASML es la única empresa del mundo que fabrica escáneres EUV. Una máquina EUV estándar cuesta bastante más de 150 millones de dólares; la nueva versión High-NA, que imprime líneas más finas, se estima en unos 380 millones. ASML prevé entregar unos 65 sistemas EUV estándar en 2026 y sus previsiones (guidance) de ingresos son de 43.000–45.000 millones de euros. Intel entregó en 2026 el primer producto de gran volumen fabricado con High-NA. Y por los controles a la exportación, China, que compró casi la mitad de las máquinas de ASML en 2024, supondrá alrededor del 20% de las ventas de 2026 según las previsiones.
Todos los demás en la fábrica
Imprimir es un paso entre varios cientos. Una oblea de vanguardia pasa por entre 500 y más de 1.000 pasos de proceso y unas 90 capas de máscara, y pasa de tres a cuatro meses en la fábrica. El resto de pasos pertenece a un puñado de empresas:
| Empresa | Qué hace | Por qué es difícil de sustituir |
|---|---|---|
| Applied Materials | Deposición, grabado, implantación, pulido | La gama de herramientas más amplia del sector. También tiene cerca del 9% de BESI, el líder en hybrid bonding. Trimestre récord de 9.100 millones de dólares en julio de 2026 |
| Lam Research | Grabado y deposición | Líder en los grabados profundos y estrechos de los que dependen la NAND 3D y la HBM |
| Tokyo Electron | Recubridoras/reveladoras, grabado, deposición | Cerca del 100% de las recubridoras/reveladoras que acompañan a cada escáner EUV (estimación) |
| KLA | Inspección y medición | Más del 85% de la inspección óptica de obleas (estimación). Sin ella, las fábricas no encuentran los defectos |
| Advantest | Pruebas de chips | El 66% de los equipos de prueba para chips lógicos como las GPU, según su propia estimación. Cada chip de IA se prueba antes de encapsularse |
| Disco | Corte y rectificado | La mayoría de las sierras de corte y rectificadoras del mundo. El rectificado es lo que deja los chips de HBM lo bastante finos para apilarlos |
SEMI contabiliza 135.000 millones de dólares de equipos vendidos en 2025, con China como mayor comprador con 49.000 millones, y prevé que el equipo para fábricas de obleas alcance 144.000 millones en 2026, un 23% más.
Capa 5: las fábricas
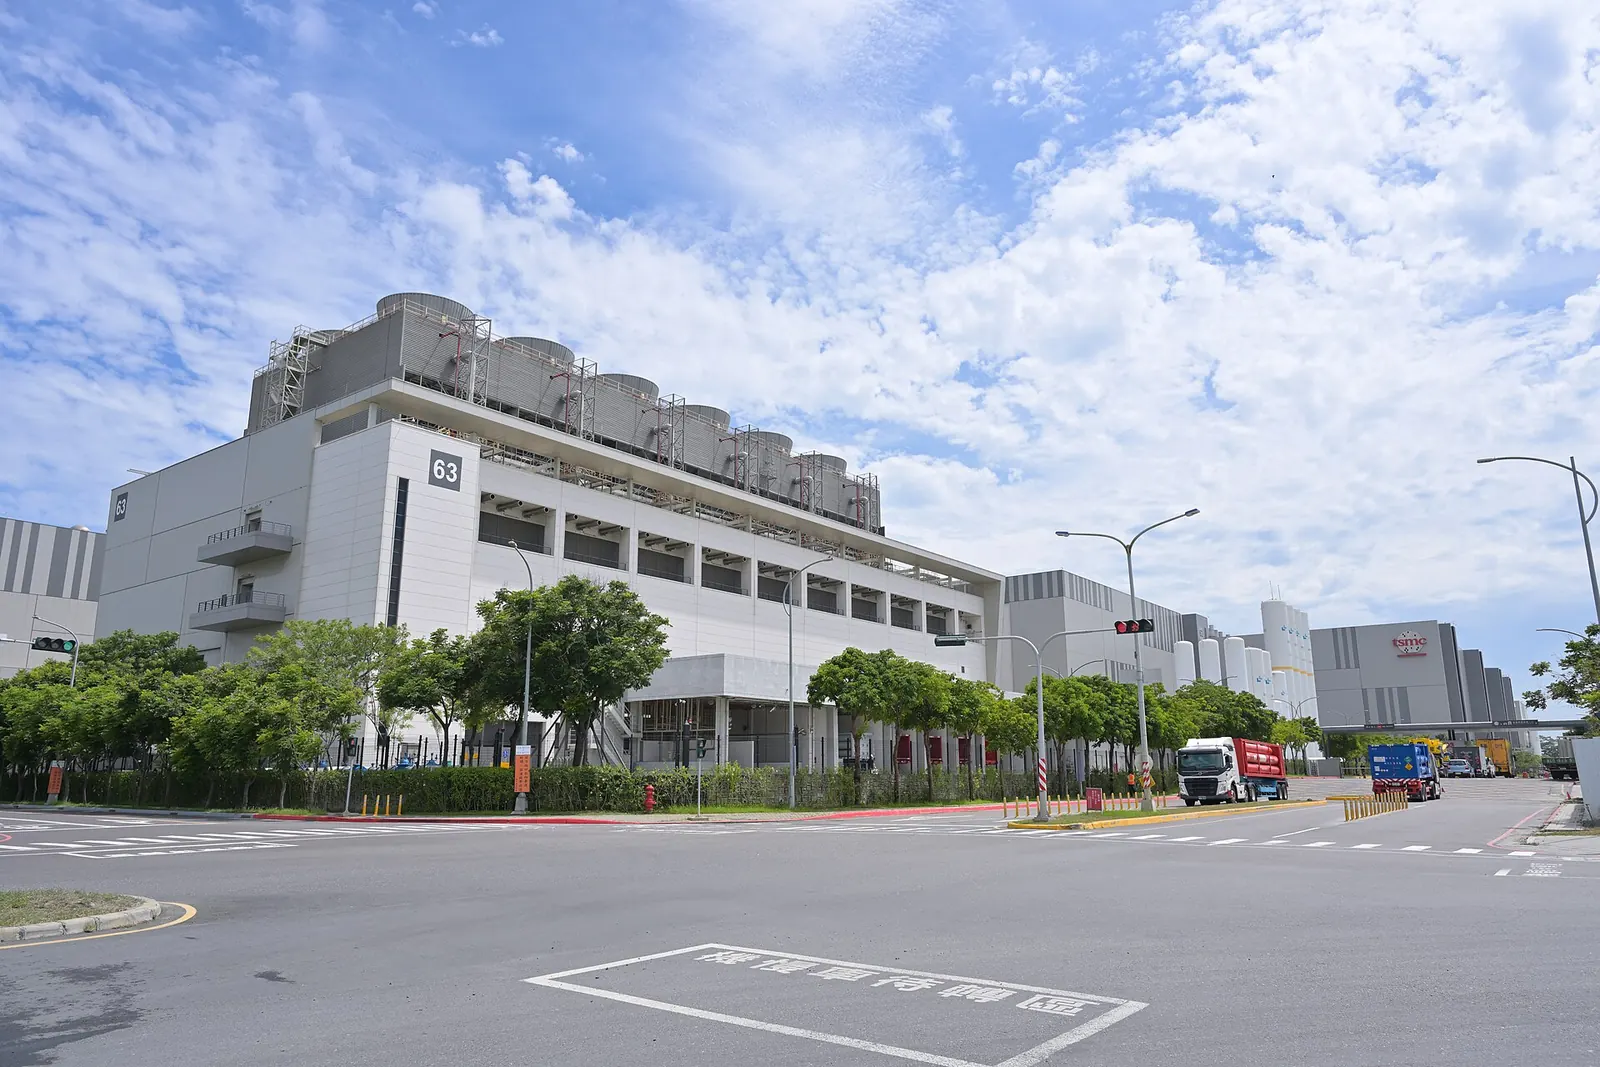
TSMC fabrica casi todos los aceleradores de IA del mundo: los de NVIDIA, los de AMD, la TPU de Google, Trainium de Amazon, Maia de Microsoft, los chips a medida de Broadcom y las obleas de Cerebras. Tuvo el 72,5% de todos los ingresos de fundición en el segundo trimestre de 2026, según TrendForce. En chips de IA de vanguardia su cuota es, en la práctica, la totalidad, aunque nadie publica esa cifra.
Los resultados muestran lo que vale esa posición. En el segundo trimestre de 2026 los ingresos de TSMC subieron un 34%, hasta 40.200 millones de dólares, con un margen bruto del 67,7%, y la computación de alto rendimiento supuso el 66% del total. Su proceso de 2 nm (N2) empezó a generar ingresos ese trimestre y debería llegar a unas 100.000 obleas al mes a finales de 2026, según estimaciones de analistas. Una oblea de 2 nm cuesta alrededor de 30.000 dólares. Elevó su inversión de 2026 a 60.000–64.000 millones de dólares. En agosto de 2026 sus ingresos mensuales marcaron un récord de 515.000 millones de dólares taiwaneses, un 53% más interanual.
Lo que hace única a TSMC no es solo su tecnología de proceso. Es que lleva cuarenta años como fundición pura que nunca compite con sus clientes, así que todos los diseñadores de chips le confían sus diseños, y los ingresos de cada generación financian la siguiente. Una fábrica de vanguardia cuesta ya unos 28.000 millones de dólares (estimación de IBS). Pocas empresas pueden reunir ese dinero; menos aún pueden llenarla.
Las alternativas existen, pero son pequeñas. Samsung Foundry tiene el 5,9% del mercado. Su mayor éxito en IA es un contrato de 16.500 millones de dólares con Tesla, hasta 2033, para fabricar el chip AI6 de Tesla en Taylor, Texas. Intel es la única empresa estadounidense que fabrica lógica de vanguardia. Su proceso 18A está en producción en volumen, el 14A debe entrar en producción de riesgo en 2027, y en 2025 recibió 8.900 millones de dólares del Gobierno de EE. UU. (a cambio del 9,9%), 5.000 millones de NVIDIA y 2.000 millones de SoftBank. Todavía gana poco con clientes externos (293 millones de dólares de ingresos de fundición externa en el segundo trimestre de 2026), pero tiene dos cosas que TSMC no tiene: es estadounidense, y sus chips x86 Xeon están dentro de los propios sistemas de NVIDIA como procesador anfitrión. También vende su encapsulado EMIB a otros fabricantes de chips como alternativa al de TSMC. La japonesa Rapidus intenta llegar a los 2 nm en 2027, pero todavía no ha firmado ningún cliente de volumen.
Capa 6: encapsulado y memoria
Este es el tramo del viaje que pilló desprevenido al sector.
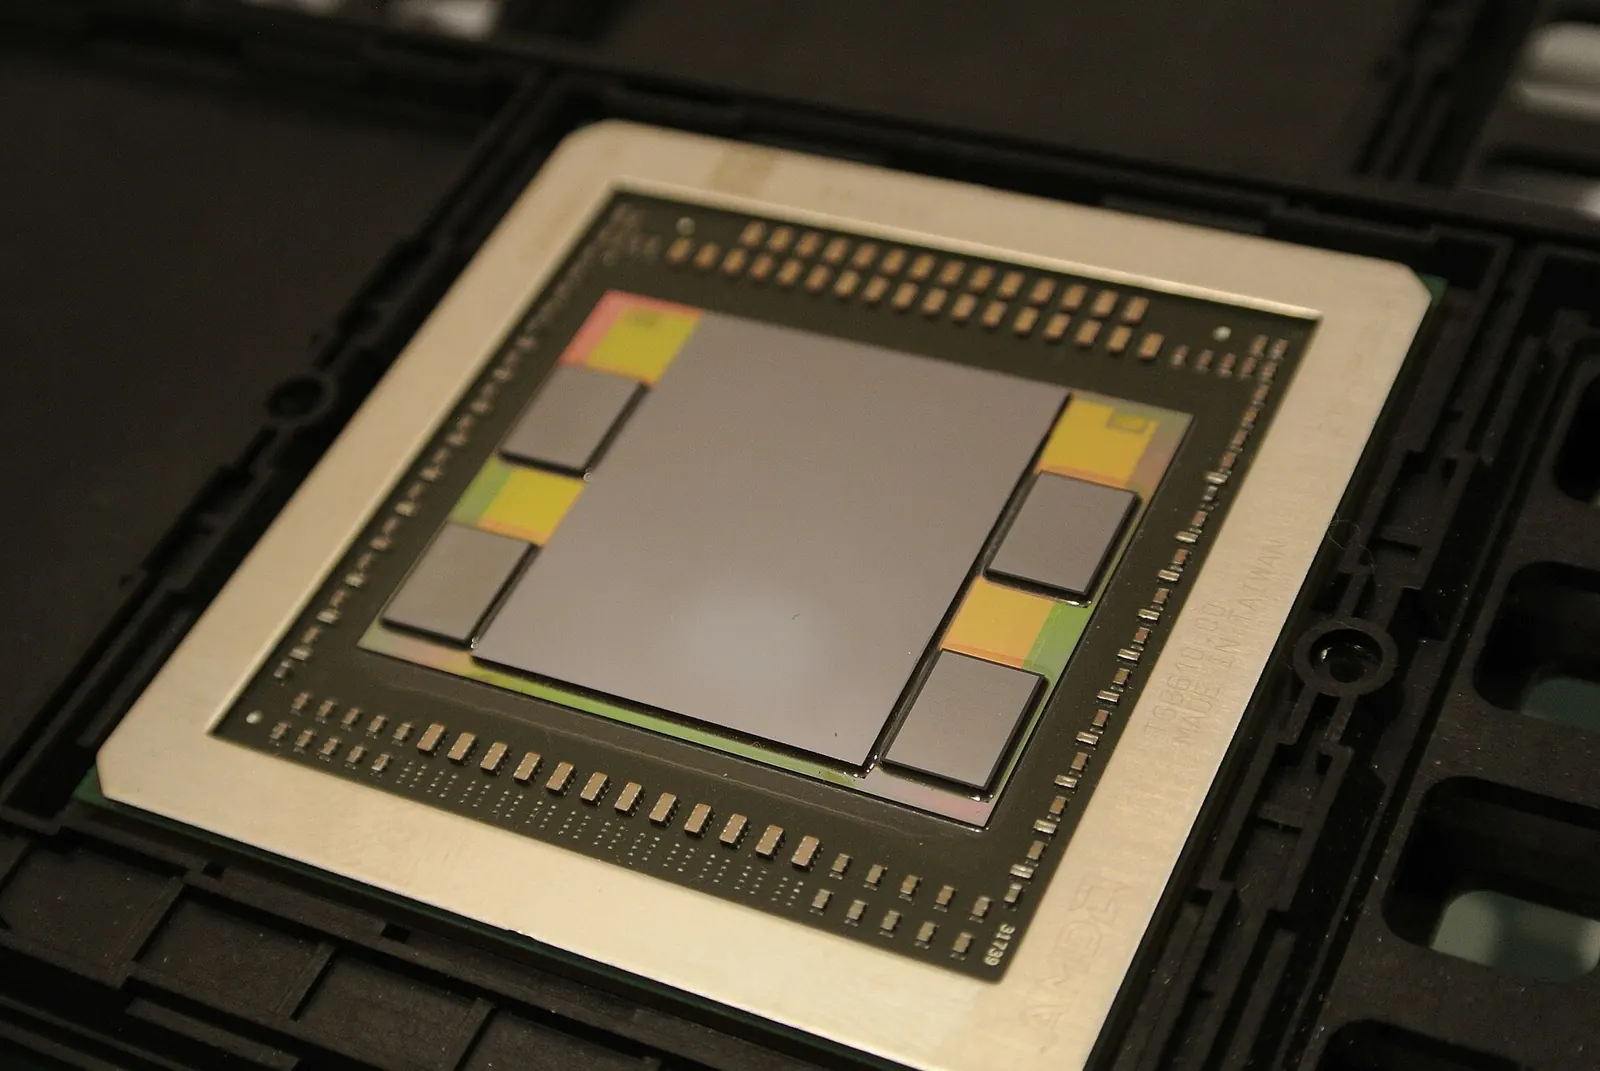
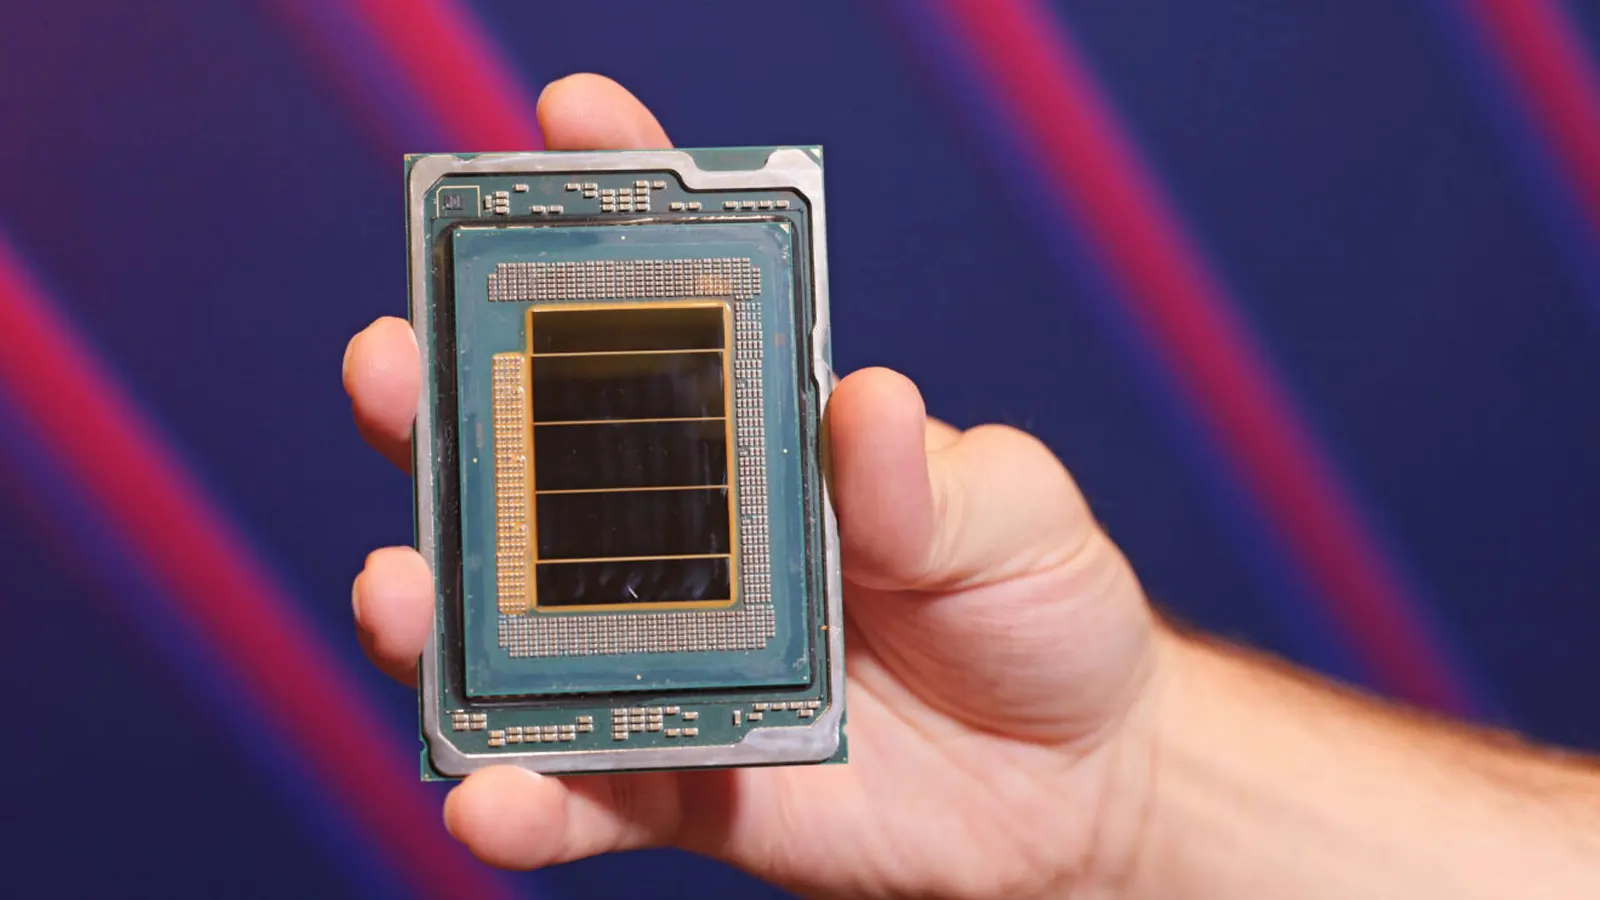
Un acelerador de IA no es un chip. Es un sistema de chips montado en un encapsulado: chips de cálculo en el centro, pilas de memoria de alto ancho de banda a su alrededor, todo sobre un interposer que los conecta con miles de conexiones por milímetro cuadrado. La versión de TSMC se llama CoWoS, siglas de Chip-on-Wafer-on-Substrate. Antes de 2023 era un producto de nicho para unos pocos superordenadores. Luego, de golpe, todos los chips de IA lo necesitaron.
La capacidad de CoWoS de TSMC ha pasado de unas 30.000–40.000 obleas al mes a finales de 2024 a unas 70.000–80.000 a finales de 2025, y se dirige a 120.000–140.000 a finales de 2026, según TrendForce y otros analistas. Todavía no ha alcanzado a la demanda: se estima que el déficit se reducirá del 20% al 10% a final de año, y NVIDIA tiene reservado alrededor del 60% de la capacidad de CoWoS de TSMC para 2026–27. TSMC dijo en su conferencia de julio que el encapsulado sigue «extremadamente ajustado». Lo que no cabe va a los ensambladores externos. ASE elevó su inversión de 2026 a un récord de 10.500 millones de dólares y espera que sus ingresos por encapsulado avanzado se multipliquen por más de dos este año. Amkor construye un complejo de encapsulado de 7.000 millones de dólares en Arizona.
Memoria de alto ancho de banda
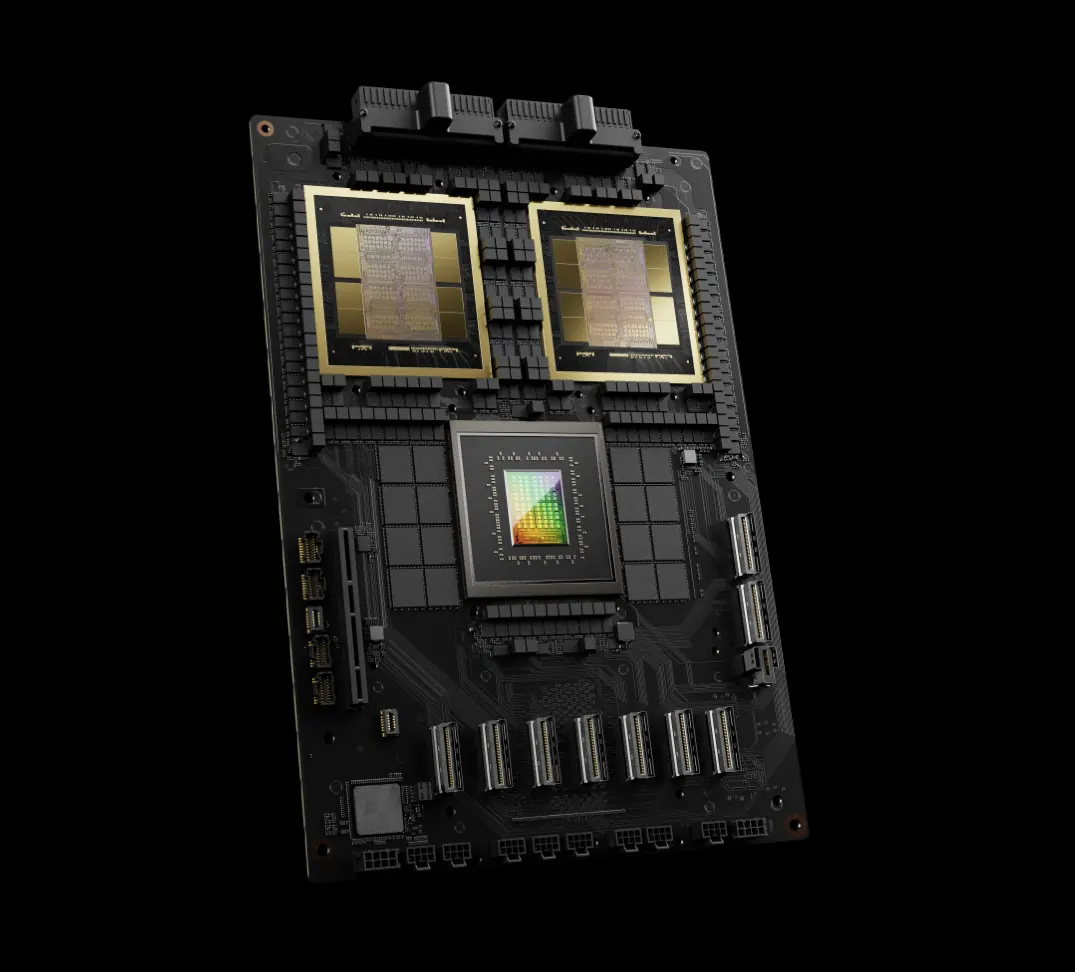
Cada torre de esa imagen es una pila de HBM: doce chips de DRAM, cada uno rectificado hasta ser más fino que un pelo, apilados y conectados a través de miles de orificios verticales llamados vías de silicio pasante (TSV). La clave es la anchura. Un chip de memoria normal se comunica por un bus estrecho; una pila de HBM4 lo hace por una interfaz de 2.048 bits situada a pocos milímetros del procesador. Una GPU Rubin de NVIDIA lleva ocho pilas, 288 GB, a 22 terabytes por segundo.
La HBM existe por un problema que lleva una década empeorando. Los cálculos que puede hacer una GPU han crecido mucho más deprisa que el ritmo al que la memoria puede alimentarla.
Solo tres empresas fabrican HBM.
SK hynix apostó pronto por la HBM, cuando era un producto de nicho para tarjetas gráficas, y es el principal proveedor de NVIDIA. En el segundo trimestre de 2026 obtuvo un beneficio operativo de 60,5 billones de wones sobre unos ingresos de 79,3 billones de wones, un margen del 76%. Samsung, que tuvo problemas para homologar su HBM3E con NVIDIA, empezó la producción en masa de HBM4 en febrero de 2026 y ha duplicado su cuota en un año. Micron es el único fabricante estadounidense. En su trimestre cerrado en mayo de 2026 facturó 41.500 millones de dólares, frente a 9.300 millones un año antes, con un margen bruto del 84,6%. En diciembre de 2025 cerró Crucial, su marca de consumo con 29 años de historia, para dedicar cada oblea a productos para centros de datos.
El apilado es una subindustria en sí misma. La coreana Hanmi Semiconductor tiene alrededor del 71% de las soldadoras por termocompresión que se usan para apilar HBM, según TechInsights. A partir de la HBM4E el sector espera pasar al hybrid bonding, que une cobre con cobre directamente sin microesferas de soldadura, y esa es la especialidad de BESI: sus pedidos se multiplicaron por más de dos en el segundo trimestre de 2026 y ya tiene 21 clientes de hybrid bonding.
El auge de la memoria llega a la flash
Como la HBM usa unas tres veces más superficie de oblea que la DRAM normal para la misma capacidad, cada pila de HBM le quita oferta a la DRAM que va a servidores y PC. El resultado en 2025–26 fue la subida de precios de la memoria más brusca de la historia del sector. TrendForce calcula que los precios de contrato de la DRAM convencional subieron entre un 93% y un 98% en un solo trimestre, el primero de 2026.
La memoria flash fue detrás, por otro motivo. Cuando un modelo atiende una conversación larga, guarda una caché del estado de atención de cada token hasta ese momento (la caché KV, que vuelve a aparecer en la sección de inferencia). Esa caché crece con la longitud del contexto y puede llegar a decenas de gigabytes por usuario. No cabe en la HBM, así que se desborda a la memoria de la CPU y después a los SSD. NVIDIA presentó en enero de 2026 un nivel de almacenamiento pensado exactamente para esto, construido sobre sus procesadores BlueField-4 y racks de unidades flash.
SanDisk, escindida de Western Digital en febrero de 2025 como empresa pura de flash, es el ejemplo más claro de lo que eso supuso. Sus ingresos de centros de datos subieron un 437% en su último trimestre, sus ingresos del ejercicio fiscal crecieron un 175%, hasta 20.300 millones de dólares, y su acción fue la que mejor se comportó del S&P 500 en 2025. Trabaja con SK hynix en la «flash de alto ancho de banda», que apila NAND como la HBM para dar a los aceleradores un nivel de memoria grande y más lento. Las primeras muestras llegarán en la segunda mitad de 2026. Kioxia y Seagate (discos duros, que siguen guardando la mayor parte de los datos de entrenamiento de IA del mundo) van en la misma ola.
Capa 7: los chips
NVIDIA
NVIDIA es el centro de la cadena, y las cifras lo demuestran. En el trimestre cerrado en julio de 2026 sus ingresos fueron de 96.200 millones de dólares, un 106% más interanual, con un margen bruto del 75%. Los centros de datos aportaron 89.000 millones, y sus previsiones para el trimestre siguiente son de 108.000 millones. La dirección dijo que el crecimiento del año que viene rondará el 70%, limitado por la oferta, y que la demanda sin restricciones sería aproximadamente el doble. En la conferencia, la directora financiera dijo que NVIDIA podría capturar unos 40.000 millones de dólares de ingresos por cada gigavatio de centro de datos construido con sus nuevos chips Vera Rubin.
Lo que hace única a NVIDIA no es solo la GPU. Vende el rack entero como un solo producto: GPU, CPU (Grace, y ahora Vera), los switches NVLink que unen 72 GPU en una sola, las tarjetas de red, los procesadores de datos, los switches Ethernet e InfiniBand y, por debajo de todo, CUDA, la plataforma de software con unos seis millones de desarrolladores y veinte años de bibliotecas. Un competidor puede igualar un chip. Igualar el sistema completo, y el software que la gente ya ha escrito para él, es mucho más difícil.
La generación actual es Blackwell. Una GPU B200 tiene 208.000 millones de transistores repartidos en dos chips y 192 GB de HBM3E a 8 TB/s; la versión Blackwell Ultra lleva 288 GB. La siguiente generación, Vera Rubin, entró en plena producción en agosto de 2026. Combina GPU Rubin (288 GB de HBM4, 22 TB/s y 50 petaflops de inferencia en 4 bits cada una) con CPU Vera de 88 núcleos Arm propios, y la dirección espera que Rubin suponga alrededor de una quinta parte de los ingresos de centros de datos en su primer trimestre completo. Después llegarán Rubin Ultra en 2027, en racks «Kyber» de unos 600 kW cada uno, y Feynman en 2028.
NVIDIA también ha ido comprando su entrada en el resto de la cadena. En diciembre de 2025 pagó unos 20.000 millones de dólares por una licencia de la tecnología de chips de inferencia de Groq y fichó a su cúpula; los racks «LPX» derivados de Groq ya están en producción. Invirtió 5.000 millones de dólares en Intel, 2.000 millones en Synopsys, hasta 10.000 millones en Anthropic y unos 30.000 millones en la ronda de financiación de OpenAI de 2026.
Las alternativas
- AMD es la única empresa, además de NVIDIA, que vende un sistema de GPU a escala de rack en el mercado abierto, y la única que además tiene una CPU de servidor líder. Su MI455X lleva 432 GB de HBM4, más memoria por GPU que la de NVIDIA. Su rack «Helios» reúne 72. OpenAI firmó en octubre de 2025 por 6 gigavatios a lo largo de varias generaciones, a cambio de warrants por hasta el 10% de AMD, y Anthropic ha firmado por hasta 2 GW. Los ingresos de centros de datos de AMD se multiplicaron por más de dos, hasta 6.700 millones de dólares, en el segundo trimestre de 2026.
- La TPU de Google es la alternativa más madura. Ironwood, la séptima generación, une 9.216 chips en un solo pod. Google ya alquila TPU fuera de su propia nube: Anthropic acordó en octubre de 2025 usar hasta un millón, y Meta las alquila y negocia comprarlas para sus propios edificios. Broadcom las codiseña. Sus ingresos por chips de IA fueron de 16.700 millones de dólares el último trimestre, un 221% más.
- Trainium de Amazon, diseñado por su filial Annapurna Labs, mueve Project Rainier, un clúster de unos 500.000 chips Trainium2 construido para Anthropic. Trainium3, en 3 nm, ya está disponible de forma general.
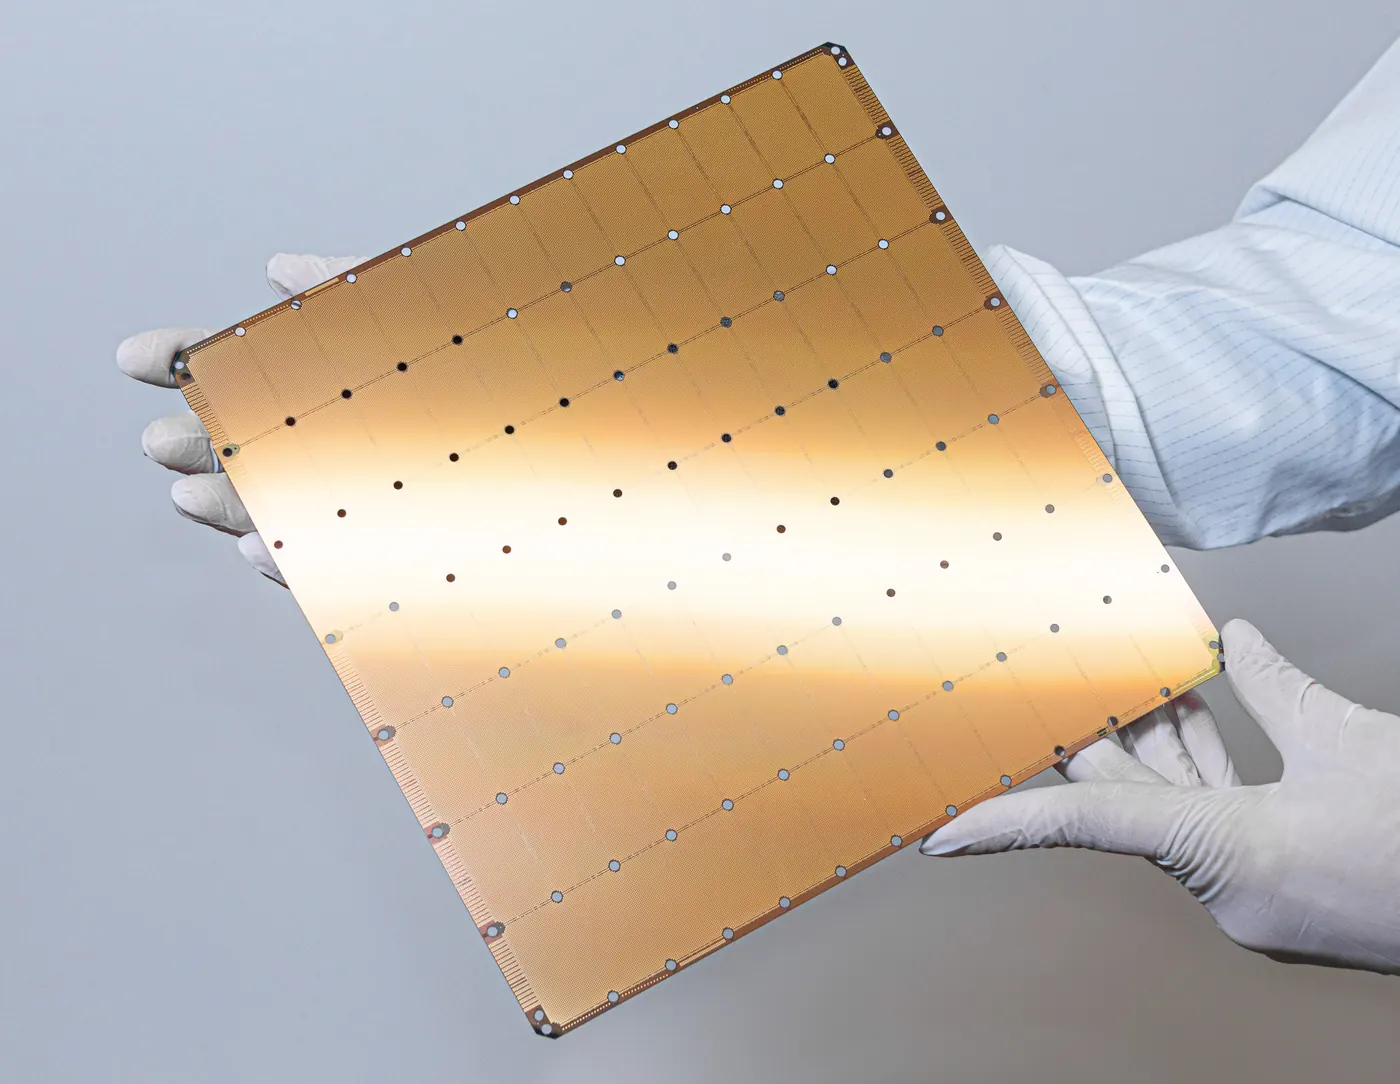
- Cerebras fabrica el único chip que es una oblea entera: 46.225 milímetros cuadrados, 4 billones de transistores y 44 GB de memoria en el propio chip. Mantener los pesos del modelo en la memoria del chip le permite generar tokens muy deprisa. OpenAI firmó en enero de 2026 un contrato de más de 10.000 millones de dólares por 750 megavatios de capacidad de Cerebras. Cerebras salió a bolsa en mayo de 2026, captó 5.550 millones de dólares y sus acciones abrieron a más del doble del precio de salida. Su principal riesgo es la concentración: dos clientes vinculados entre sí en Emiratos Árabes Unidos supusieron el 86% de sus ingresos de 2025.
- Maia 200 de Microsoft, MTIA de Meta, Etched (un chip que solo ejecuta transformers) y Tenstorrent (RISC-V abierto) completan el panorama.
Las CPU vuelven a importar
Durante unos años, la CPU de un servidor de IA fue algo secundario: un procesador anfitrión para alimentar ocho GPU. Los agentes cambiaron eso. Un agente pasa buena parte del tiempo ejecutando código, llamando a herramientas, buscando y esperando, y todo eso se ejecuta en CPU. TrendForce dice que la proporción de CPU por GPU en los clústeres de IA ha pasado de 1:8 a 1:4 y se dirige a 1:1. Arm calcula que un centro de datos agéntico necesita unas cuatro veces más núcleos de CPU por gigavatio que uno de IA clásico. Intel y AMD subieron los precios de sus CPU de servidor en 2026, y los plazos de entrega de algunos modelos superaron las 30 semanas. Los ingresos de centros de datos de Intel subieron un 59% el último trimestre. Resulta que el veterano del x86 también es una empresa de IA.
Capa 8: los sistemas
Los chips se convierten en servidores, y los servidores en racks. La unidad de la computación de IA es ahora el rack, no el servidor.
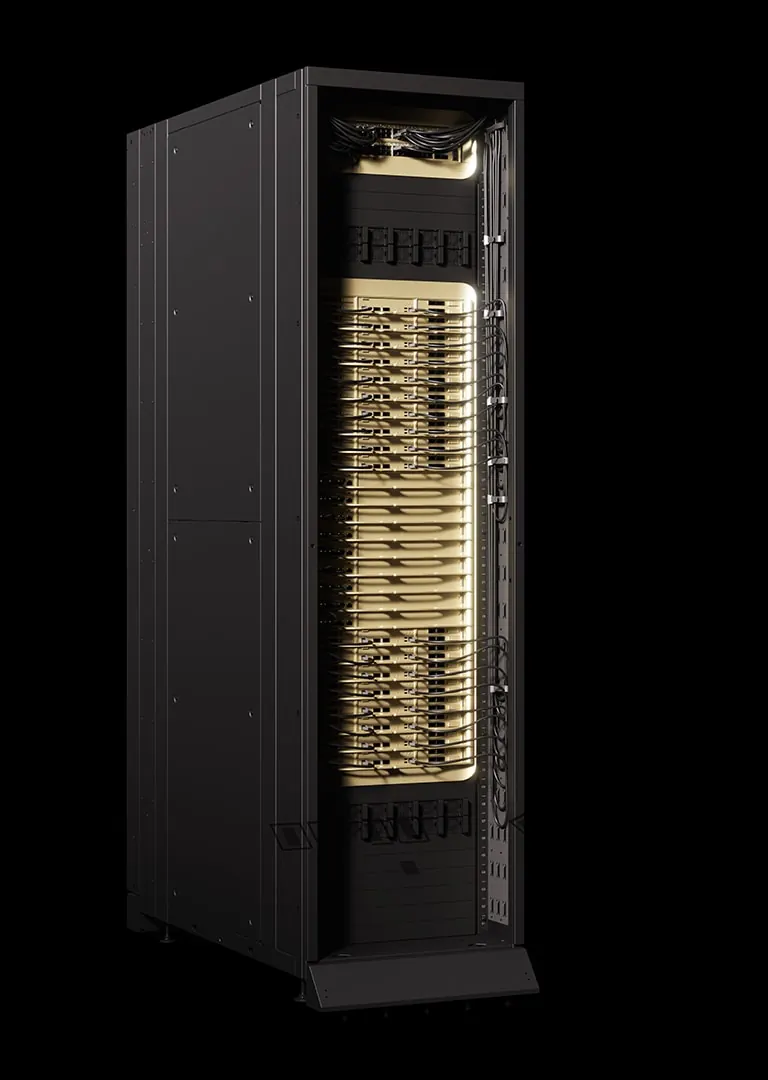
El GB300 NVL72 de NVIDIA mete 72 GPU y 36 CPU en un solo rack refrigerado por líquido que consume unos 135 kW y pesa alrededor de tonelada y media. Las 72 GPU se unen a través de nueve bandejas de switches NVLink mediante una columna de unos 5.000 cables de cobre, dos millas en total (más de tres kilómetros), en lo que se comporta como una sola GPU enorme con 20 TB de HBM.
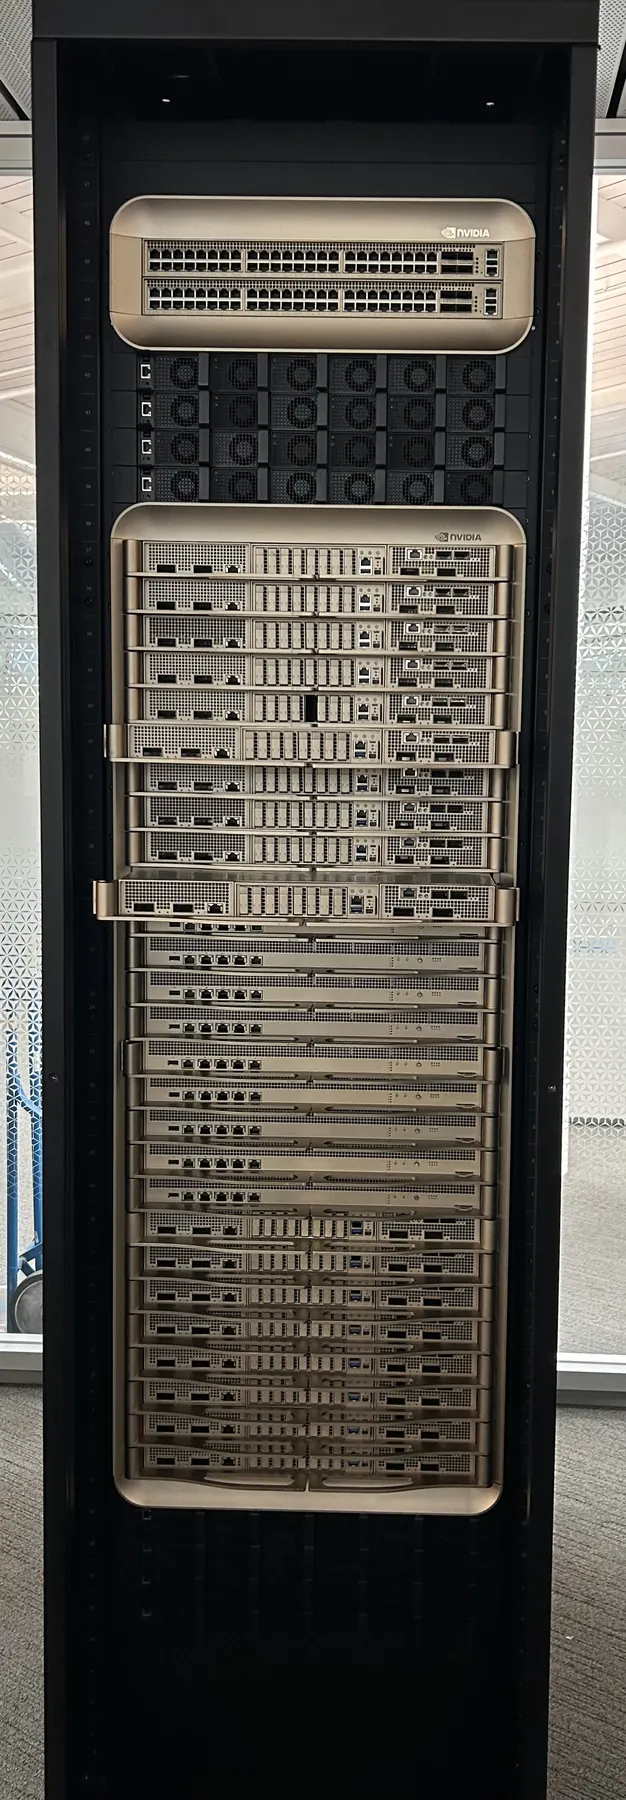
Racks como este se montan sobre todo en Taiwán y México, en manos de fabricantes de diseño original (ODM). Foxconn es el mayor: los servidores de IA superaron por primera vez la mitad de sus ingresos en el segundo trimestre de 2026. Quanta, Wistron y Wiwynn son los demás. Los fabricantes de servidores con marca venden los racks, los financian, los instalan y les dan soporte.
Dell se ha convertido en el mayor fabricante con marca de racks de IA, y vende a neoclouds, proyectos soberanos y empresas. En el trimestre cerrado en julio de 2026 registró 60.900 millones de dólares en pedidos de servidores de IA, y su cartera de IA pasó de 51.000 a 95.000 millones en tres meses. Elevó su previsión de ingresos por servidores de IA para todo el año a 74.000 millones y señaló la memoria, la flash, las CPU y los discos duros como sus limitaciones. Supermicro, HPE y Lenovo también crecen deprisa, pero con márgenes mucho más estrechos: el margen bruto de Supermicro fue del 17,5%. El negocio de servidores aporta valor sobre todo mediante la integración, la rapidez y la financiación, y el mercado lo valora en consecuencia.
Las piezas pequeñas que importan
Dentro de cada rack hay componentes de unos pocos dólares o de unos pocos cientos sin los que el rack no puede funcionar. Dos de los más interesantes pertenecen a empresas de las que casi nadie ha oído hablar.
SiTime fabrica chips de temporización: los osciladores y generadores de reloj que marcan el pulso de todos los demás chips. Un enlace serie que funciona a 200 gigabits por segundo por carril tiene que muestrear su señal en el instante exacto, billones de veces por segundo, y un módulo óptico o una tarjeta de red tiene que mantenerse sincronizado con el del otro extremo. La diferencia de SiTime es que sus resonadores son estructuras microscópicas de silicio (MEMS) en lugar de los cristales de cuarzo que llevan un siglo marcando el tiempo en la electrónica. Son más pequeños, resisten mejor las vibraciones y el calor, y se fabrican en fábricas de chips corrientes. Antes era un nicho. Ahora la IA es su mayor mercado: los ingresos de SiTime subieron un 127%, hasta 157 millones de dólares, en el segundo trimestre de 2026, su segmento de comunicaciones, empresas y centros de datos creció un 181%, y en julio cerró la compra del negocio de temporización de Renesas por 1.500 millones de dólares.
Vicor resuelve otro problema físico. Lo trato en la sección de energía, más abajo, porque solo se entiende cuando ves cuántos amperios consume una GPU.
Capa 9: la red
Entrenar una IA es un deporte de equipo que juegan decenas de miles de chips, y pasan una parte sorprendente del tiempo esperándose unos a otros. Por eso la red que los conecta importa casi tanto como los chips. Tiene tres escalas. Scale-up hace que un grupo de GPU actúe como una sola (NVLink dentro de un rack). Scale-out conecta racks dentro de un edificio mediante InfiniBand o Ethernet. Scale-across une edificios y campus en un solo clúster. Para cada distancia el medio adecuado es distinto.
El cobre, estirado
El cobre gana en distancias cortas porque no necesita conversión: entra una señal eléctrica y sale una señal eléctrica. El problema es que, a 200 gigabits por segundo por carril, la señal de un cable de cobre pasivo se degrada en un par de metros.
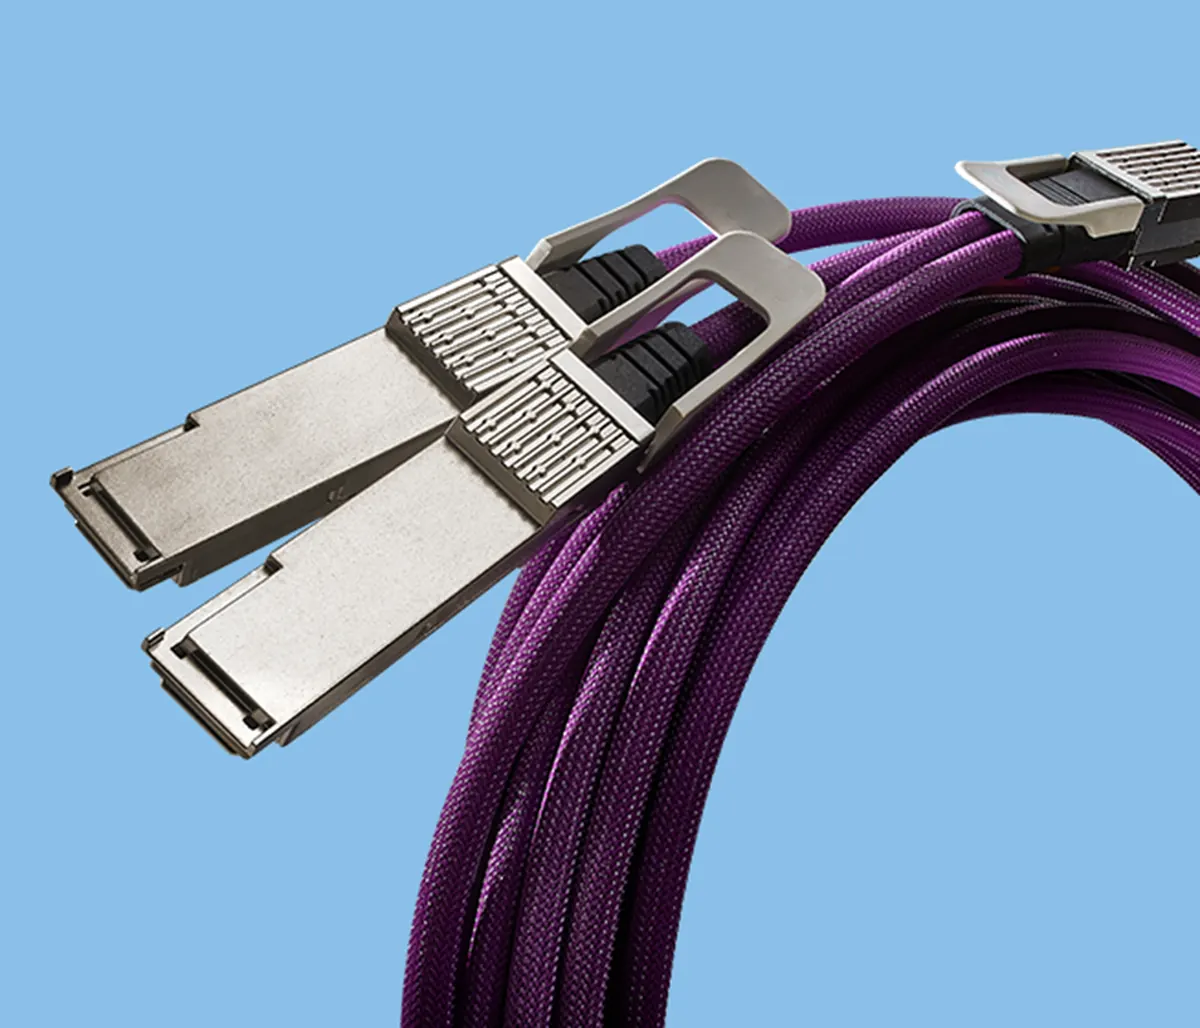
Credo encontró un término medio: el cable eléctrico activo, o AEC. Es un cable de cobre con un pequeño chip en cada conector que limpia y resincroniza la señal, lo que estira el alcance del cobre hasta unos siete metros. Basta para conectar los servidores con el switch de la parte superior del rack, o racks vecinos entre sí. Credo asegura que un AEC consume hasta 14 vatios menos por enlace que la alternativa óptica y cuesta menos, y, según Credo, algo igual de importante en un clúster de 100.000 GPU: falla menos, porque no tiene láseres que se degraden. Sus cables morados se ven en racks de AWS, Microsoft, xAI y Meta. En el trimestre cerrado en julio de 2026 los ingresos de Credo crecieron un 115%, hasta 479 millones de dólares, su séptimo trimestre consecutivo de crecimiento de tres dígitos. Su ventaja es que diseña sus propios SerDes de muy bajo consumo (los circuitos que envían y reciben señales de alta velocidad) y vende cables y módulos ópticos terminados con software de diagnóstico, no solo chips. Ahora también está entrando en la óptica.
Astera Labs fabrica los retimers que estiran las señales PCIe a lo largo de una placa de circuito, y ahora también chips de switch para redes scale-up. Sus ingresos se duplicaron en términos interanuales el último trimestre y sus previsiones apuntan a otro salto del 40% este trimestre. Marvell suministra los procesadores digitales de señal que llevan la mayoría de los módulos ópticos de alta velocidad y, con la compra de Celestial AI por 3.250 millones de dólares, apuesta a que la luz acabará llegando también al interior del rack.
La luz
A partir de unos pocos metros, la señal se convierte en luz. Un transceptor óptico, un módulo del tamaño de un paquete de chicles, convierte las señales eléctricas en pulsos láser y viceversa. Un clúster de NVIDIA usa aproximadamente un transceptor de 800 gigabits por GPU solo en su red interna. Los láseres de dentro son de fosfuro de indio, y se convirtieron en uno de los cuellos de botella de 2026.
- Coherent es la más integrada verticalmente: fabrica obleas de fosfuro de indio, láseres y transceptores terminados, y construyó las primeras fábricas del mundo de fosfuro de indio de seis pulgadas, en Texas y Suecia, que reducen el coste por láser en torno a un 60%. Sus ingresos de centros de datos y comunicaciones subieron un 59% el último trimestre.
- Lumentum fabrica los láseres que van dentro de los módulos de otras empresas, además de conmutadores ópticos de circuitos: espejos que redirigen físicamente la luz entre fibras, algo en lo que Google fue pionera en sus clústeres de TPU. Sus ingresos se duplicaron el último trimestre hasta algo más de 1.000 millones de dólares, y se dice que tiene la producción vendida hasta 2028.
- Innolight y Eoptolink, en China, fabrican la mayoría de los transceptores de 800 gigabits y 1,6 terabits del mundo. Fabrinet, en Tailandia, ensambla óptica para NVIDIA y Cisco.
- El silicio de los switches viene de Broadcom (Tomahawk 6, el primer chip de switch de 102,4 terabits) y de NVIDIA (Spectrum-X). Los equipos vienen de Arista, cuyos ingresos superaron los 3.000 millones de dólares por trimestre, y de Cisco, que recibió 9.300 millones de dólares en pedidos de infraestructura de IA de los hiperescaladores en su último ejercicio fiscal.
- La óptica coempaquetada de NVIDIA (láseres montados junto al chip de switch en lugar de en módulos enchufables) promete multiplicar por 3,5 la eficiencia energética. Sus primeros switches con esta tecnología ya se están entregando.
Entre edificios, la fibra transporta óptica coherente, que codifica los datos en la fase de la luz, la misma técnica que usan las redes de telecomunicaciones de larga distancia. Ciena lidera este segmento, y los proveedores de nube ya suponen más de la mitad de sus ingresos. En los océanos, los hiperescaladores poseen o alquilan alrededor de tres cuartas partes de todo el ancho de banda internacional, y construyen sus propios cables. Project Waterworth, de Meta, tendrá 50.000 km, más que la circunferencia de la Tierra. Los cables los tienden SubCom, ASN y NEC, que entre las tres construyen alrededor del 90% de los sistemas submarinos del mundo.
Capa 10: los edificios
La electricidad, de la red al transistor
Este es el diagrama que mejor explica por qué es difícil construir centros de datos de IA.
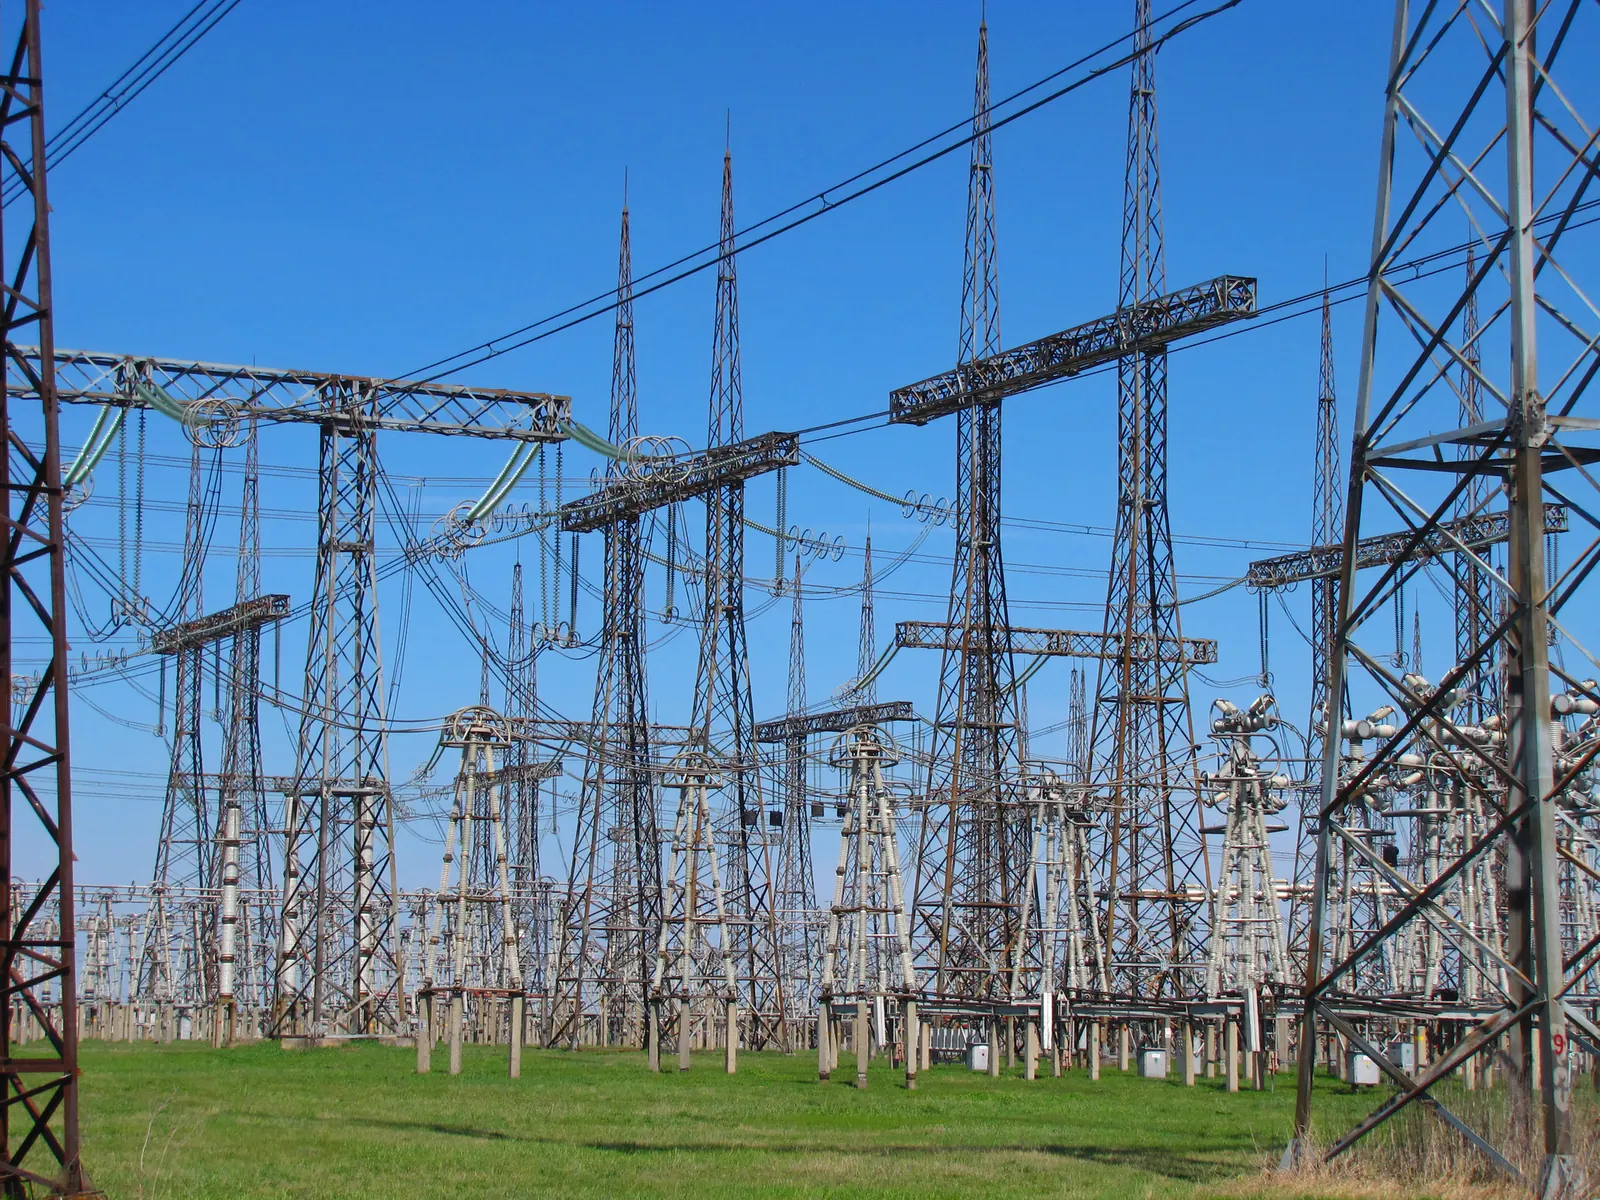
La electricidad llega a un centro de datos a cientos de miles de voltios y tiene que llegar a la GPU a menos de un voltio. Cada escalón de bajada en la tensión es un escalón de subida en la corriente, porque la potencia es voltios por amperios. Al final de la cadena, una GPU que consume unos 1,4 kW a 0,8 V necesita unos 1.750 amperios. Como comparación, una vivienda en EE. UU. suele tener una acometida de 200. Y hay que entregarlos a un chip de pocos centímetros, a través de la placa, sin fundir nada ni perder la mitad de la energía en forma de calor por el camino.
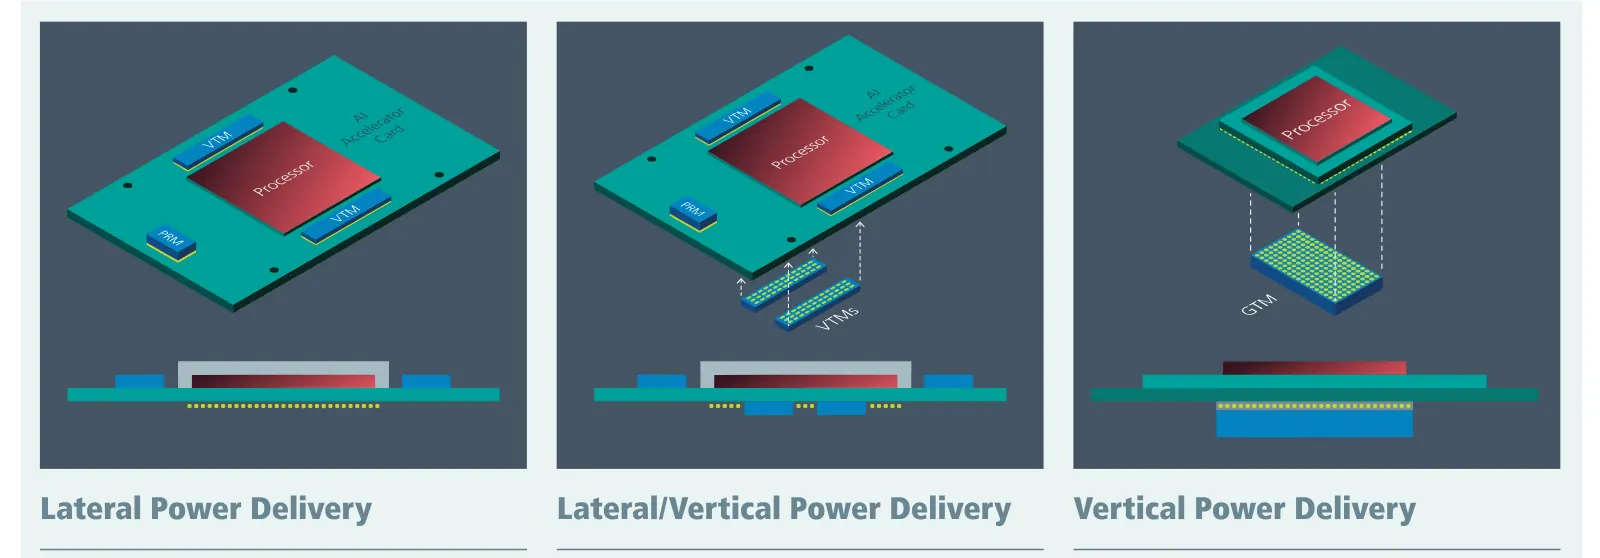
Toda la empresa de Vicor está construida sobre ese último centímetro. Los reguladores de tensión tradicionales se sitúan junto al procesador y empujan la corriente lateralmente a través de la placa de circuito, lo que desperdicia energía y ocupa espacio. La «Factorized Power Architecture» de Vicor divide la conversión en dos etapas, y su «vertical power delivery» coloca la etapa final justo debajo del procesador, inyectando la corriente directamente hacia arriba. Su segunda generación alcanza tres amperios por milímetro cuadrado. Vicor también ha defendido sus patentes con dureza: tras un caso ante la Comisión de Comercio Internacional de EE. UU., ha firmado una licencia que le paga 5 millones de dólares por trimestre en royalties este año y 10 millones el que viene, y un segundo caso contra convertidores sin licencia tiene la decisión final prevista para 2027. Es una empresa pequeña, con unos 600 millones de dólares de ingresos previstos para 2026 y una cartera a un año que sube un 145%, dueña de una propiedad intelectual inusualmente específica. Monolithic Power Systems, Infineon y Renesas son sus principales competidores para ese mismo trabajo.
Más arriba en la escalera, los equipos eléctricos vienen de Schneider Electric, Eaton, ABB y Vertiv (aparamenta, sistemas de alimentación ininterrumpida, conductos de barras), y los estantes de alimentación de los racks, sobre todo de las taiwanesas Delta y Lite-On. La línea discontinua del diagrama es el próximo gran cambio. Para sus racks Kyber de 2027, que consumen hasta 600 kW cada uno, NVIDIA pasa a corriente continua de 800 voltios llevada directamente al rack. Eso reduce el cobre en torno a un 45% y elimina varios pasos de conversión. Depende de interruptores de potencia de carburo de silicio y nitruro de galio (Infineon, onsemi, STMicro, Navitas, Wolfspeed), materiales que hasta ahora se conocían sobre todo por los coches eléctricos.
El calor
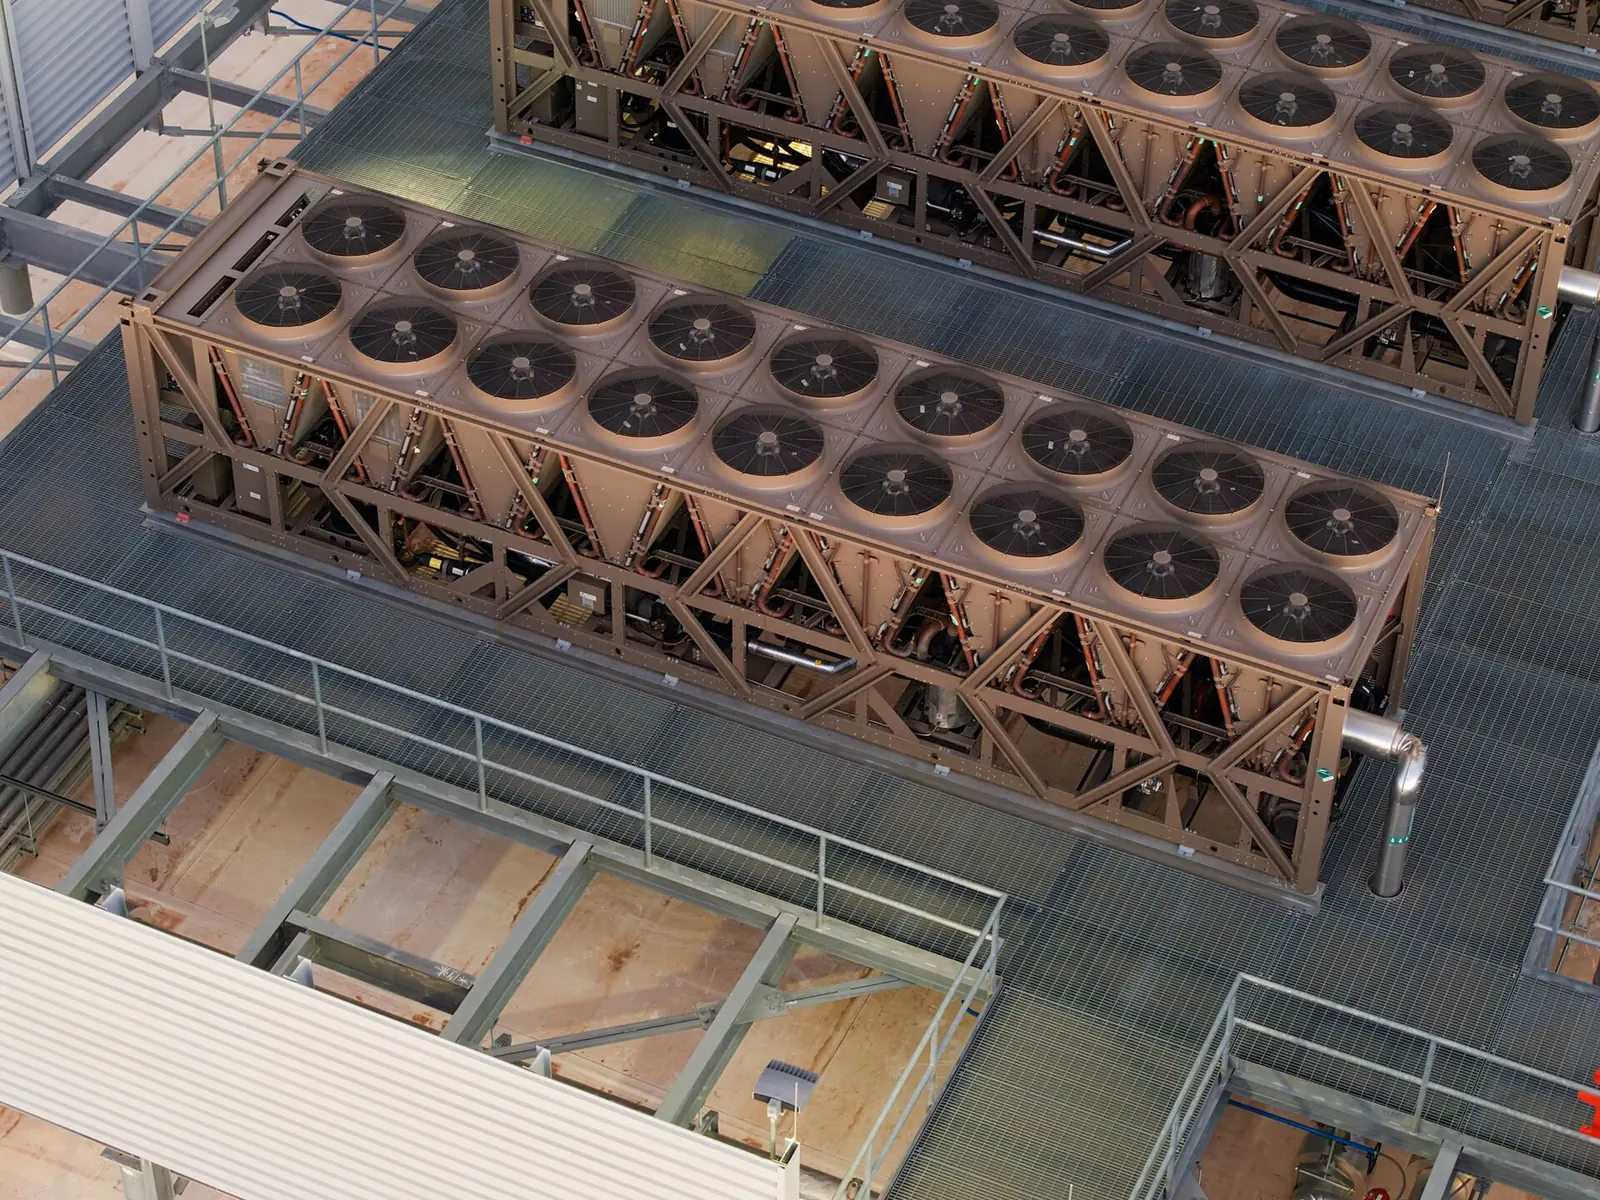
Casi cada vatio que entra en un chip sale en forma de calor. A 135 kW por rack, el aire no puede evacuarlo lo bastante deprisa, así que el calor sale en líquido: sobre cada chip hay placas frías, alimentadas por unidades de distribución de refrigerante que bombean agua a través del rack y hacia enfriadoras o aerorrefrigeradores secos. TrendForce calcula que el 53% de los chips de IA entregados en 2026 se refrigerarán por líquido, frente al 33% de 2025.
Vertiv es la empresa más ligada a este cambio. Vende las dos mitades de las instalaciones mecánicas y eléctricas del edificio (electricidad: SAI, aparamenta, conductos de barras; térmica: CDU, enfriadoras, disipación de calor) y codiseña arquitecturas de referencia con NVIDIA, de modo que un cliente que construye para la próxima generación de GPU puede comprar un conjunto a juego. Sus ingresos crecieron un 24% en el segundo trimestre de 2026, pero sus pedidos orgánicos subieron un 152%, lo que dice más sobre hacia dónde va. Sus competidores se están concentrando para alcanzarla: Eaton compró Boyd Thermal por 9.500 millones de dólares y Schneider compró Motivair.
Los centros de datos mejor gestionados son ya notablemente eficientes. La flota de Google funciona con una eficacia en el uso de la energía (PUE) de 1,09, lo que significa que solo el 9% de la energía va a algo que no sean los ordenadores, frente a una media del sector de 1,54. El emplazamiento Fairwater de Microsoft en Wisconsin usa un sistema de líquido en circuito cerrado que solo necesita agua cuando se llena por primera vez.
Capa 11: la energía
Los centros de datos consumieron unos 415 teravatios hora de electricidad en 2024, alrededor del 1,5% del suministro mundial, según la Agencia Internacional de la Energía. Su escenario base lo multiplica por más de dos, hasta 945 TWh en 2030, y los servidores acelerados explican cerca de la mitad del aumento. En EE. UU., el Lawrence Berkeley National Laboratory calcula que los centros de datos pasaron de 58 TWh en 2014 a 176 TWh en 2023, el 4,4% de toda la electricidad, y proyecta entre el 6,7% y el 12% para 2028.
En 2024 esa electricidad procedió del carbón (30%), las renovables (27%), el gas (26%) y la nuclear (15%). La cuota del carbón es alta por China. En EE. UU., el gas suministra más del 40% de la electricidad de los centros de datos y, junto con las renovables, se espera que cubra la mayor parte del aumento hasta 2030. Lo que ha cambiado es que los mayores compradores ya no quieren esperar a la red.
Turbinas de gas, agotadas
La forma más rápida de añadir potencia firme es una turbina de gas, y solo hay tres grandes fabricantes: GE Vernova, Siemens Energy y Mitsubishi Power. La cartera de gas y las reservas de turno de GE Vernova alcanzaron 116 gigavatios en el segundo trimestre de 2026. Ya acepta reservas para 2031 y espera tener más de la mitad de ese año comprometida a finales de 2026. Los centros de datos son alrededor de una quinta parte de sus clientes de gas, y sus pedidos de centros de datos en el primer semestre de 2026 duplicaron con creces los de todo 2025. Algunos promotores han ido más allá y han puesto las turbinas en el propio emplazamiento: Colossus 2, de xAI, en Memphis, tiene una central de gas propia de 1,2 GW con permiso.
Bloom Energy: electricidad sin red y sin llama
Bloom Energy fabrica pilas de combustible de óxido sólido, que convierten gas natural (o hidrógeno) en electricidad por vía química, sin combustión, en armarios que se pueden instalar en bloques modulares. Lo que realmente vende es rapidez. Un centro de datos que no puede conseguir conexión a la red en cinco años, ni una turbina hasta 2030, puede instalar las unidades de Bloom en meses, junto al edificio, con emisiones locales mucho menores que si quemara el mismo gas. Ese argumento convirtió a Bloom de una empresa de energía limpia de nicho en infraestructura de IA. American Electric Power firmó en enero de 2026 un contrato de 2.650 millones de dólares por hasta 1 GW; Brookfield comprometió hasta 5.000 millones en octubre de 2025; Oracle, Equinix y «todos los grandes hiperescaladores de EE. UU.» han homologado sus sistemas. En el segundo trimestre de 2026 sus ingresos subieron un 166%, hasta más de 1.000 millones de dólares, y sus previsiones apuntan a aproximadamente duplicarlos en el año.
La nuclear, más adelante
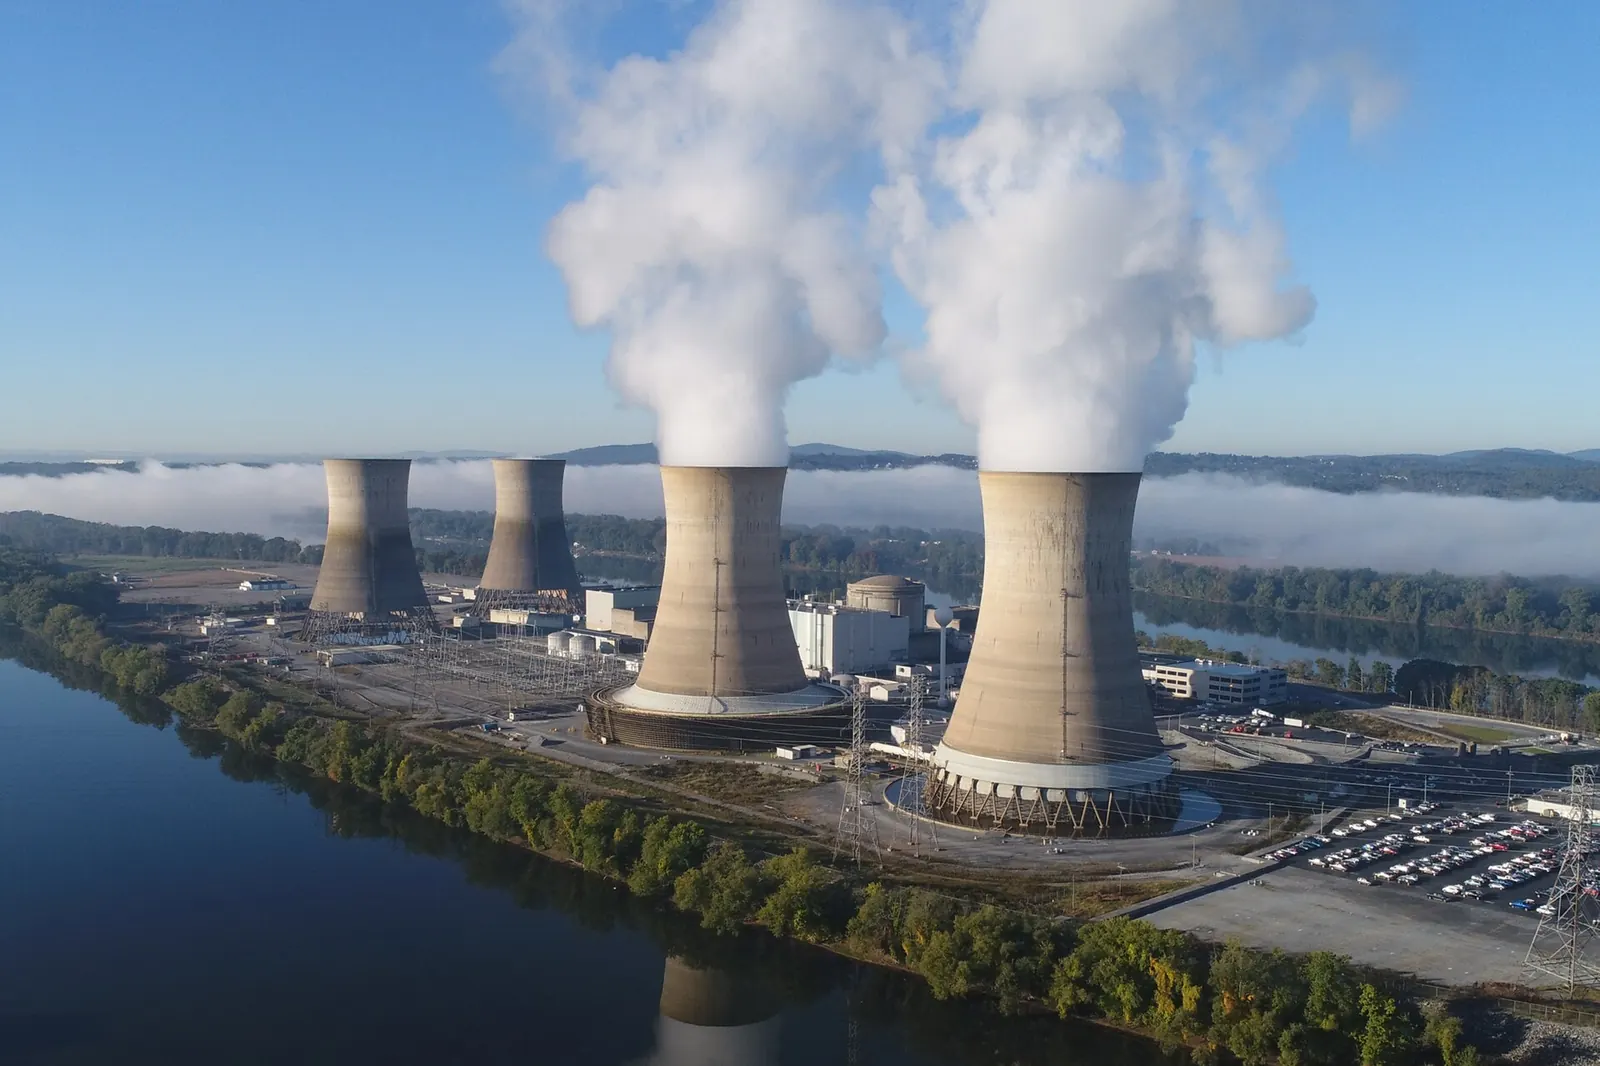
Los acuerdos nucleares son los más llamativos y los más lentos. Microsoft paga por reabrir la unidad 1 de Three Mile Island, rebautizada Crane Clean Energy Center, con Constellation, con 2027 como objetivo. Amazon compra 1,92 GW a la central de Susquehanna, de Talen. Meta firmó en enero de 2026 acuerdos por hasta 6,6 GW hasta 2035 con Vistra (centrales existentes), TerraPower y Oklo (reactores nuevos). Google respalda a Kairos Power y Amazon a X-energy. La mayoría de los reactores nuevos llegarán después de 2030. En esta década, el peso lo llevan el gas, la solar con baterías y las pilas de combustible.
Los campus y el dinero
Si se junta todo esto, salen campus que se miden en gigavatios. Stargate, de OpenAI, Oracle y SoftBank, había anunciado unos 7 GW de emplazamientos a finales de 2025, empezando por Abilene, Texas, construido por Crusoe. Hyperion, de Meta, en Luisiana, está previsto para 5 GW. xAI construyó Colossus 1 en Memphis en 122 días. Fairwater, de Microsoft, en Wisconsin, tiene 120 millas (casi 200 kilómetros) de cable de media tensión. Anthropic comprometió 50.000 millones de dólares para sus propios centros de datos en Texas y Nueva York con Fluidstack. A su alrededor están los neoclouds (CoreWeave, Nebius, Crusoe) y los caseros de colocation (Equinix, Digital Realty), que alquilan espacio, electricidad y, cada vez más, GPU.
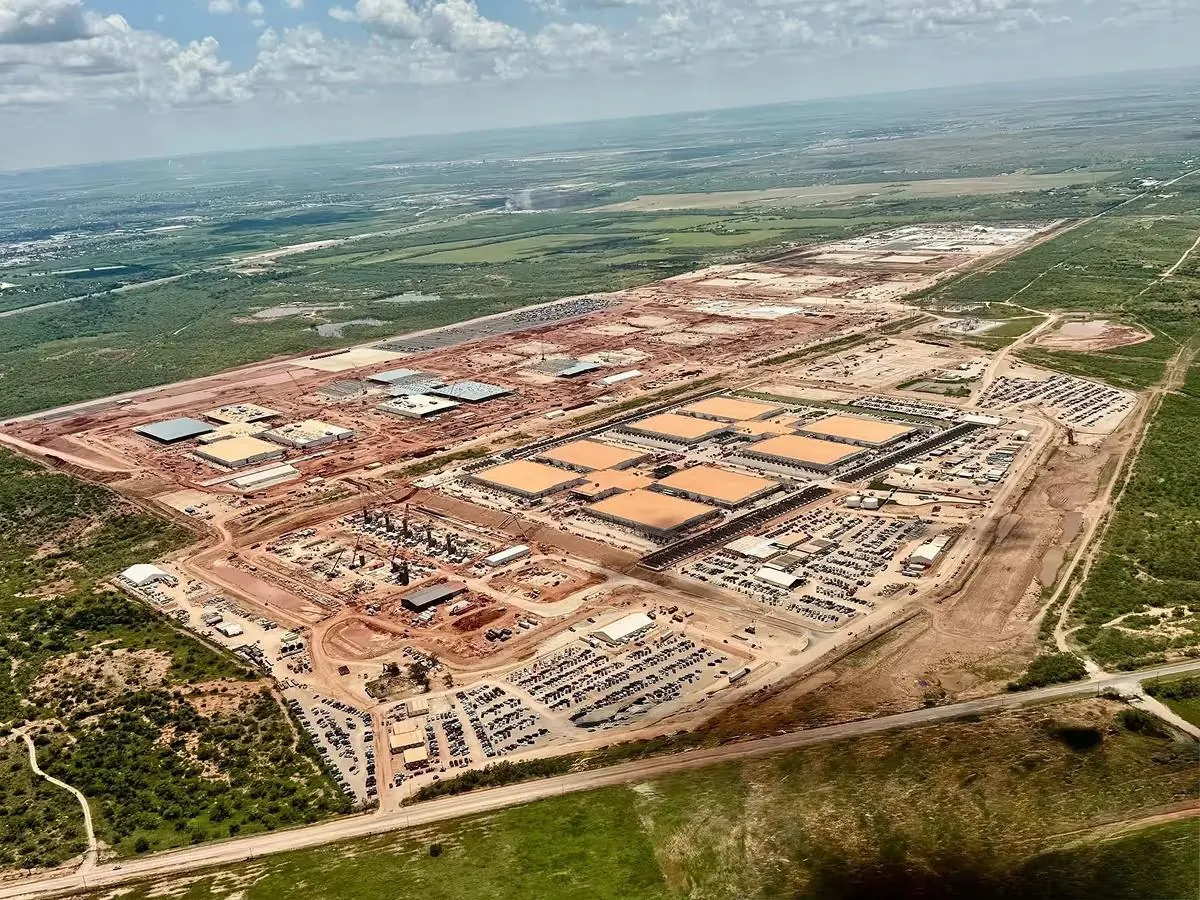
Es el mayor programa de inversión privada de la historia. Amazon prevé unos 220.000 millones de dólares de inversión en 2026; Alphabet, 195.000–205.000 millones; Meta, 130.000–145.000 millones. Oracle espera 90.000–95.000 millones brutos en su ejercicio fiscal actual y tiene 664.000 millones de ingresos futuros contratados. El consejero delegado de Amazon dijo que la empresa «seguirá sin tener capacidad suficiente» en 2026, y que lo mismo ocurrirá en 2027. NVIDIA sitúa a los cinco mayores hiperescaladores en casi 800.000 millones de dólares este año y 1,3 billones el que viene.
Las cifras por gigavatio muestran cómo se reparte el dinero. NVIDIA dice que puede capturar unos 40.000 millones de dólares de un gigavatio de la generación Rubin, y Huang cifró un año antes el coste total de un gigavatio en 50.000–60.000 millones. Buena parte de la cadena aguas arriba (las obleas de TSMC, la HBM, el encapsulado, los sustratos) se paga dentro de la parte de NVIDIA, porque es NVIDIA quien compra esas piezas. Lo que queda fuera, quizá entre una cuarta y una tercera parte del total, paga los equipos eléctricos, la refrigeración, el resto de la red, el edificio, el terreno y la conexión a la red eléctrica. Es un trozo más pequeño por gigavatio, pero se cobra en cada gigavatio, sean de quien sean los chips que van dentro.
Capa 12: los modelos
Ahora, el software, donde los minerales por fin se convierten en un LLM: cómo convierte la gente de los laboratorios de IA todo este hardware en un modelo.
La mayor parte del cómputo se va en experimentos
La primera sorpresa es adónde va el cómputo. El famoso entrenamiento, el que produce el modelo que se publica, es la punta de una pirámide. Antes, los investigadores lanzan cientos o miles de experimentos más pequeños para decidir la receta: la arquitectura, la mezcla de datos, el calendario de la tasa de aprendizaje, qué tamaño elegir. Ajustan esos entrenamientos pequeños a leyes de escalado y extrapolan al grande.
Epoch AI calcula que en 2024 OpenAI gastó unos 5.000 millones de dólares en cómputo de investigación, de los que solo alrededor del 10% se destinó a los entrenamientos finales de los modelos que publicó. En MiniMax y Zhipu (Z.ai), dos laboratorios chinos, la proporción fue del 12–23%. La mayor parte del presupuesto de cómputo de un laboratorio se gasta en aprender a entrenar, no en entrenar.
La receta
Datos. Un modelo de frontera empieza con decenas de billones de tokens (un token equivale más o menos a tres cuartos de palabra). La mayoría se rastrea de la web. El conjunto de datos abierto FineWeb, de Hugging Face, con 15 billones de tokens construidos a partir de 96 capturas de Common Crawl, muestra el proceso: extraer el texto, filtrar el spam y la basura con reglas y clasificadores, eliminar los casi duplicados (el paso MinHash de FineWeb compara fragmentos de cinco palabras), quitar la información personal y tokenizar. Los laboratorios añaden contenido con licencia, código, libros, matemáticas y, cada vez más, datos sintéticos generados por modelos anteriores. Llama 3, de Meta, usó unos 15 billones de tokens; Qwen3, de Alibaba, unos 36 billones, y V4, de DeepSeek, unos 33 billones. Los datos también tienen ya costes legales: Anthropic acordó en 2025 un pago de 1.500 millones de dólares con autores cuyos libros se habían sacado de webs piratas.
Preentrenamiento. El modelo, un transformer y hoy normalmente un transformer de mezcla de expertos en el que solo una fracción de los parámetros está activa para cada token, aprende a predecir el siguiente token, una y otra vez, durante meses. DeepSeek-V3 tenía 671.000 millones de parámetros pero solo usaba 37.000 millones por token. Su entrenamiento final necesitó 2,8 millones de horas de GPU en 2.048 H800, que DeepSeek valoró en 5,6 millones de dólares, sin contar todos los experimentos previos. Los mayores entrenamientos son mucho más grandes. Epoch estima Grok 4 en unas 5×10²⁶ operaciones de coma flotante, 246 millones de horas de H100 y unos 490 millones de dólares. GPT-6 Astra, de OpenAI, publicado este mes, es el primero que ha preentrenado con más de 100.000 GPU, y la estimación preliminar de Epoch es de unas 10²⁷ operaciones. Epoch dice que el cómputo de entrenamiento de frontera se ha multiplicado por unas cinco cada año desde 2020.
Paralelismo. Ninguna GPU puede contener un modelo de frontera, y menos aún entrenarlo sola, así que el trabajo se divide de varias maneras a la vez.
Las herramientas para esto son sobre todo de código abierto. PyTorch, de Meta, es el framework dominante, con FSDP para repartir los modelos entre GPU y TorchTitan para combinar cuatro tipos de paralelismo. Google y otros laboratorios usan JAX, compilado por XLA para las TPU; Anthropic ha dicho que usa PyTorch, JAX y Triton, el lenguaje de OpenAI para escribir kernels de GPU. Megatron-Core, de NVIDIA, y DeepSpeed, de Microsoft, aportan las recetas de paralelismo a gran escala de las que parten muchos laboratorios. Los trabajos se planifican con Slurm o Kubernetes, y los experimentos se siguen con herramientas como Weights & Biases, que CoreWeave compró por unos 1.700 millones de dólares en 2025. La precisión no deja de bajar para ahorrar memoria y energía: la mayoría de los entrenamientos se hacen ya en coma flotante de 8 bits, y NVIDIA ha demostrado que 4 bits (NVFP4) pueden igualarlo en un entrenamiento de 10 billones de tokens.
A esta escala, los fallos son rutina. El artículo de Llama 3 de Meta registró 466 interrupciones en 54 días con 16.384 H100, más o menos una cada tres horas. De las inesperadas, alrededor del 78% se atribuyeron al hardware, y la memoria HBM por sí sola causó el 17%. Los puntos de control, los reinicios automáticos y la capacidad de reserva forman parte del entrenamiento tanto como las matemáticas.
Postentrenamiento. Un modelo preentrenado es un autocompletado excelente, no un asistente. El postentrenamiento lo convierte en uno. Empieza con un ajuste fino supervisado sobre ejemplos escritos por expertos, sigue con aprendizaje a partir de preferencias (el RLHF que hizo posible ChatGPT en 2022, y variantes como la Constitutional AI de Anthropic y DPO) y ahora se apoya mucho en el aprendizaje por refuerzo con recompensas verificables: el modelo intenta un problema de matemáticas o una tarea de programación miles de veces, y se refuerzan los intentos que pasan las pruebas. Así se hicieron los modelos de razonamiento, y se ha vuelto caro. xAI dijo que Grok 4 hizo aprendizaje por refuerzo «a escala de preentrenamiento».
Eso creó una cadena de suministro propia. Los laboratorios compran entornos de RL: webs, aplicaciones y bases de código simuladas en las que los agentes pueden practicar tareas. Epoch informa de que una réplica de una web sencilla cuesta unos 20.000 dólares y la de una aplicación compleja como Slack, unos 300.000. También compran datos de expertos a empresas como Scale AI (participada al 49% por Meta desde junio de 2025), Surge AI, Mercor y Turing, que pagan a médicos, abogados e ingenieros para que escriban y califiquen ejemplos. Se ha publicado que Mercor por sí sola ha superado un ritmo de ingresos de 2.000 millones de dólares anuales.
Evaluación y seguridad. Antes de publicarse, los modelos se someten a benchmarks, a ataques de equipos rojos internos y externos y a pruebas de capacidades peligrosas, y después se lanzan por fases. Es el paso más corto en tiempo de calendario y el que decide si todo lo anterior sale a la luz.
Y, cada vez más, los modelos ayudan a construir a sus sucesores. Anthropic informó de que más del 80% del código integrado en la empresa en mayo de 2026 lo escribió Claude, y de que un ingeniero típico integraba ocho veces más código al día que en 2024.
Capa 13: la inferencia, o cómo te llega la respuesta
El entrenamiento ocurre una vez. La inferencia, ejecutar el modelo para responder peticiones, ocurre cada vez que alguien lo usa, y ya es el negocio más grande. Esto es lo que pasa cuando pulsas Intro.
Tu petición viaja al centro de datos más cercano con capacidad, pasa por una pasarela de API y un enrutador que elige una réplica del modelo, y espera un momento en una cola. Luego el trabajo se divide en dos fases muy distintas.
El prefill lee toda tu pregunta de una vez. Cada token se procesa en paralelo, así que las GPU están ocupadas haciendo cálculos, y el resultado es la caché KV: el estado de atención de cada token hasta ese momento. El decode genera después la respuesta token a token. Para cada token nuevo, la GPU tiene que volver a leer de la memoria los pesos del modelo y toda la caché KV, así que el decode está limitado por el ancho de banda de la memoria, no por el cómputo. Por eso importaba la sección de la HBM: un modelo de 70.000 millones de parámetros en precisión de 16 bits ocupa unos 140 GB, y una H100 que lo lee a 3,35 TB/s puede producir como mucho unos 24 tokens por segundo para un solo usuario. La caché KV de ese mismo modelo ocupa unos 320 KB por token, así que una conversación de 128.000 tokens necesita unos 40 GB de memoria para un solo usuario.
El software de servicio existe para sortear esos límites:
- El batching atiende a muchos usuarios a la vez, de modo que los pesos leídos de la memoria se reutilizan para todos ellos. PagedAttention, de vLLM, desarrollado en Berkeley, gestiona la memoria de la caché KV como un sistema operativo gestiona las páginas, y multiplicó el rendimiento por entre dos y cuatro frente a sistemas anteriores. vLLM, SGLang y TensorRT-LLM, de NVIDIA, son los principales motores de servicio de código abierto.
- La desagregación ejecuta el prefill y el decode en máquinas distintas, cada una ajustada para su fase, y envía la caché KV de una a otra. Dynamo, de NVIDIA, hace esto y afirma atender hasta 30 veces más peticiones de DeepSeek-R1 en sus racks Blackwell.
- La caché guarda la caché KV de las peticiones habituales (instrucciones de sistema, documentos largos) para no recalcularlas. Los proveedores trasladan el ahorro: los tokens de entrada en caché cuestan una décima parte o menos que los nuevos.
- Números más pequeños y modelos más pequeños: cuantización a 8 o 4 bits, destilación de modelos grandes en pequeños, decodificación especulativa (un modelo pequeño hace el borrador y el grande lo comprueba) y diseños de mezcla de expertos que activan una fracción de los pesos por token.
Esas técnicas, junto con mejores chips, han abaratado la inteligencia de forma espectacular. Andreessen Horowitz calculó que el precio de un nivel de capacidad dado cayó unas diez veces al año entre 2021 y 2024. Epoch encuentra una caída mediana de unas 50 veces al año en distintos benchmarks. GPT-4 costaba 30 dólares por millón de tokens de entrada en su lanzamiento, en marzo de 2023; GPT-5 salió a 1,25 dólares en 2025, y hoy los modelos pequeños de OpenAI y DeepSeek cuestan unos pocos céntimos.
A la caída de precios le ha respondido un aumento del uso.
Google procesaba 9,7 billones de tokens al mes en 2024 y más de 3.200 billones al mes en mayo de 2026. Solo su API gestionaba unos 19.000 millones de tokens por minuto. Microsoft dice que el número de clientes que funcionan a un ritmo de un billón de tokens al año se ha multiplicado por cuatro. Buena parte del tráfico nuevo son agentes, que leen y escriben mucho más por tarea que una persona charlando.
Se ha formado una nueva capa de empresas para atenderlo. Además de las API de los propios laboratorios y de las grandes nubes, especialistas en inferencia como Fireworks (valorada en 17.500 millones de dólares, con más de 1.000 millones de ingresos anualizados), Baseten y Together AI ejecutan modelos abiertos y a medida para desarrolladores, mientras Cerebras y los sistemas de NVIDIA derivados de Groq compiten en velocidad pura. OpenRouter reparte el tráfico de los desarrolladores entre todos ellos; en una sola semana de este verano, V4 Flash de DeepSeek procesó 7,2 billones de tokens solo a través de él.
Cómo se ve la cadena entera desde arriba
Si se pone lado a lado el crecimiento del último trimestre de cada capa, aparece un patrón.
El crecimiento más rápido está en lo que más escasea: la memoria, los aceleradores y los chips y cables que los conectan. El más lento está en las capas pesadas (fábricas, herramientas, refrigeración, vidrio), pero en parte es un efecto de calendario: esas empresas registran pedidos años antes de reconocer los ingresos. Los pedidos de Vertiv subieron seis veces más deprisa que sus ventas. GE Vernova está reservando turbinas para 2031.
Y la restricción que manda sigue cambiando de sitio.
En 2023 fue el encapsulado CoWoS. En 2024 fue la HBM, y luego las conexiones a la red y los transformadores. En 2025 las turbinas de gas se agotaron con años de antelación. A finales de 2025 los fabricantes de memoria se habían quedado sin DRAM ni flash, y en 2026 los láseres de fosfuro de indio y las CPU de servidor se sumaron a la lista. El presidente de Foxconn ya señala el encapsulado avanzado como el techo de 2027. Cada vez que el cuello de botella se mueve, el poder de fijación de precios se mueve con él, hacia la empresa que controla la capa escasa.
Esa es la forma más útil que he encontrado de leer esta industria. No es una sola apuesta por «la IA». Es una cadena de negocios muy distintos: una mina de cuarzo, una empresa química, un monopolio de la litografía, una fundición, tres fabricantes de memoria, un fabricante de cables, una empresa de temporización, un especialista en módulos de potencia, un fabricante de turbinas, una empresa de pilas de combustible, unos cuantos laboratorios y mucho software de servicio. Todos dependen de la misma demanda, pero cada uno tiene su propia física, sus propios competidores y su propio calendario. Cuando alguien te diga que la IA es una burbuja o una revolución, la pregunta más útil es a qué capa se refiere, y si esa capa es la que anda escasa ahora mismo.
Así que la próxima vez que un chatbot te responda en un segundo, recuerda el viaje que hay detrás: cuarzo y cobre salidos del suelo, a través de trece industrias y de algunas de las máquinas más difíciles que se han construido nunca, hasta un modelo que lo convierte todo otra vez en palabras. Esa es la aventura. Cada capa es un negocio, y todas siguen en construcción.