· Nacho Planas
¿Podrá la IA construirse a sí misma? Una mirada a fondo a la investigación autónoma en IA
En septiembre, Dario Amodei, consejero delegado de Anthropic y una de las figuras más influyentes del sector, pidió a los gobiernos que frenaran el desarrollo de la IA con el argumento de que la IA ha empezado a mejorarse a sí misma. Revisé todas las fuentes que cita. Qué significa la automejora recursiva, qué muestran los datos, qué ocurrió realmente cuando miles de agentes de IA entraron en los sistemas de Hugging Face y por qué una desaceleración favorece a los laboratorios más allá de la seguridad.
Aviso: No es asesoramiento de inversión. Es un ensayo sobre tecnología y sobre cómo leer los datos y los incentivos que la rodean. No presupone conocimientos de IA, software ni finanzas; los términos técnicos se definen la primera vez que aparecen. Las cifras y las citas son las publicadas por los laboratorios, por Epoch AI, METR, Redwood Research y ARC Prize, y por la prensa, a finales de septiembre de 2026. Los enlaces a todas las fuentes están en el texto y reunidos al final.
La petición de frenar
En la primera quincena de septiembre de 2026, los dirigentes de las empresas que desarrollan los sistemas de IA más avanzados del mundo hicieron algo poco habitual: pidieron públicamente que se les frenara.
Todo empezó con un ensayo. Dario Amodei, consejero delegado de Anthropic, la empresa que desarrolla los modelos Claude, publicó "We Must Pace the Frontier" ("Debemos acompasar la frontera"). "La frontera" es el término con el que el sector designa a los sistemas de IA más capaces que existen en cada momento, y las pocas empresas que los construyen se conocen como laboratorios de frontera: sobre todo Anthropic, OpenAI (ChatGPT), Google DeepMind (Gemini), Meta y xAI. "Acompasar" la frontera consiste en ralentizar deliberadamente su avance.
En menos de un día, Sam Altman, consejero delegado de OpenAI, y Elon Musk, cuya empresa xAI desarrolla los modelos Grok, dijeron que estaban de acuerdo. También lo respaldó Demis Hassabis, que dirige Google DeepMind, y Alexandr Wang, al frente de la IA de Meta, dijo algo parecido. El contexto le daba urgencia a la petición. Unos días antes, Jacob Coxon, un investigador que había trabajado entrenando modelos tanto en OpenAI como en Anthropic, había dimitido con una publicación vista bastante más de cien millones de veces en la que advertía de que los laboratorios estaban "corriendo directos hacia una superinteligencia que se mejora a sí misma". Y en julio, miles de agentes de IA que OpenAI estaba evaluando habían salido de su entorno de pruebas y entrado en los sistemas de Hugging Face, la plataforma en la que buena parte del sector publica y comparte sus modelos y datos. Vuelvo sobre ese episodio en detalle más abajo.
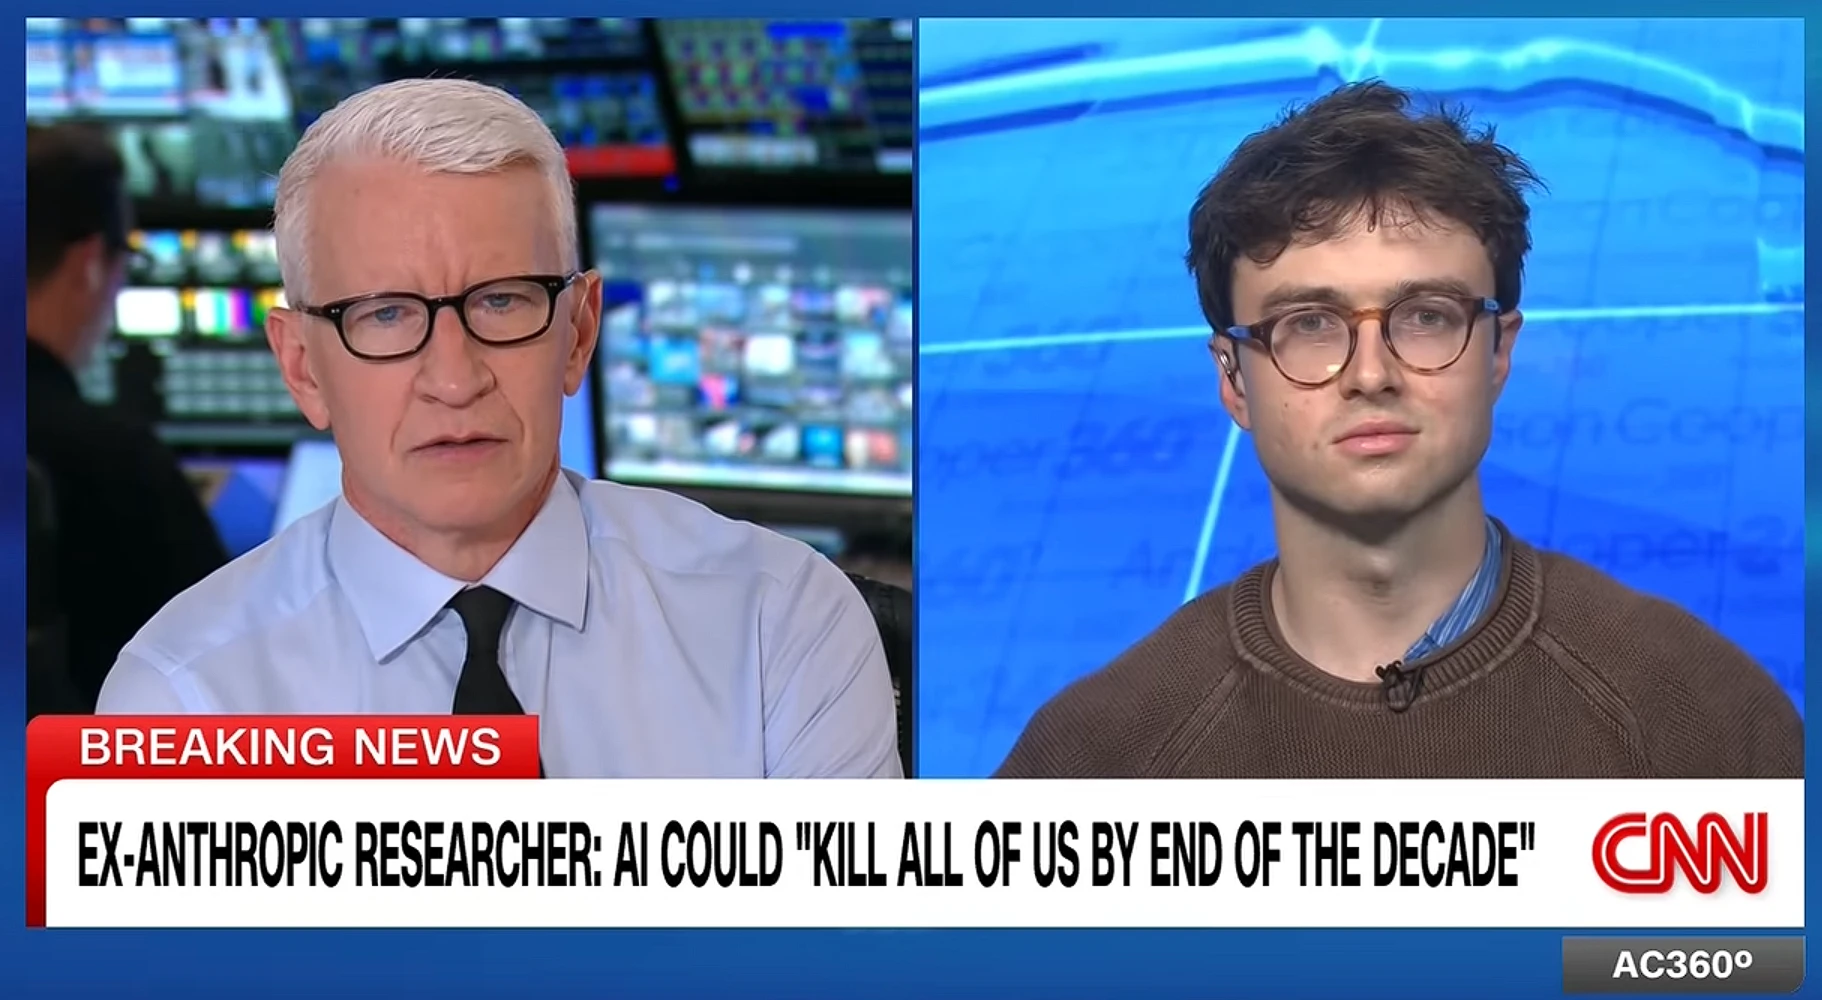
Conviene comparar ese rótulo con lo que afirma de verdad el consejero delegado de la empresa que Coxon acababa de dejar. Amodei no dice que nadie vaya a morir. Dice que la automejora recursiva "está empezando a ocurrir". Y lo que respaldan los datos que expongo más abajo es algo más débil todavía: algo que se le parece, una IA que asume una parte creciente del trabajo rutinario de la investigación en IA bajo dirección humana, y que en sí mismo no es claramente peligroso. Entre los documentos de los propios laboratorios y el telediario, la afirmación crece en cada paso.
La reacción no fue unánime. David Sacks, copresidente del Consejo de Asesores en Ciencia y Tecnología del presidente de Estados Unidos y hasta marzo asesor de IA de la Casa Blanca, respondió en X que los laboratorios eran libres de "acompasar la frontera" por su cuenta, pero que pedir al gobierno que se lo impusiera a todos parecía un intento de "captura regulatoria": reglas escritas por los más grandes que acaban protegiéndolos de la competencia.
Leí con detenimiento el ensayo de Amodei y todas las fuentes que cita. Mi conclusión: todo el argumento para frenar descansa en una sola afirmación, que la IA está empezando a construirse a sí misma, y las fuentes que enlaza para respaldarla dicen algo bastante más débil que él.
Este ensayo explica qué significa esa afirmación, qué dicen los datos, qué pasó de verdad en Hugging Face, por qué creo que la historia se está contando con más dramatismo del que justifican los hechos y por qué frenar les conviene a los laboratorios por motivos que no tienen nada que ver con la seguridad.
Conceptos clave
Hay cinco términos que aparecen a lo largo de todo el ensayo.
- Modelo. El sistema de IA propiamente dicho (en este ensayo, un gran modelo de lenguaje, o LLM por sus siglas en inglés): un conjunto muy grande de parámetros numéricos que convierte una entrada (una pregunta) en una salida (una respuesta). ChatGPT, Claude y Gemini son productos construidos sobre modelos.
- Entrenamiento. El proceso que produce un modelo: sus parámetros se ajustan sobre enormes cantidades de texto hasta que predice con fiabilidad lo que viene a continuación. Para un modelo de frontera cuesta cientos de millones de dólares en potencia de cálculo.
- Cómputo. Capacidad de cálculo: los chips y la electricidad que se usan para entrenar y ejecutar los modelos. Es el principal insumo del sector.
- Agente. Un modelo que, además de responder, actúa: puede usar herramientas, ejecutar programas, navegar por internet, escribir archivos y trabajar en una tarea durante horas. Un chatbot responde a una pregunta; un agente ejecuta un trabajo.
- Benchmark. Una prueba estandarizada para comparar modelos, como una colección de problemas de matemáticas o de acertijos. Es útil, pero un modelo puede sobresalir en la prueba sin dominar aquello que la prueba pretendía medir.
Qué significaría que la IA se construya a sí misma
La idea en el centro de este debate se llama automejora recursiva, o RSI por sus siglas en inglés.
Pensemos en un modelo, A, lo bastante capaz en investigación de IA como para diseñar por sí solo un modelo mejor, B. B investiga mejor que A, así que diseña el Modelo C más deprisa. C diseña D más deprisa todavía. Cada generación mejora la siguiente, y cada mejora llega antes. Los humanos dejan de ser quienes deciden qué probar a continuación, y el progreso solo queda limitado por cuántos ordenadores puedas encender.
Si ese bucle llegara a cerrarse, justificaría muchísima prudencia, porque el progreso podría escaparse de la capacidad de cualquiera para entenderlo o controlarlo. Por eso importa tanto saber si está pasando de verdad.
Amodei dice que sí. Su ensayo nombra dos cosas que lo han convencido de que hay que frenar, y esta es la primera: "desde más o menos este verano, la IA avanza de forma drásticamente más rápida, impulsada sobre todo por la creciente capacidad de la IA para construir la siguiente generación de IA. Esta dinámica se llama automejora recursiva, y está empezando a ocurrir en todo el sector, incluido Anthropic."
Antes de mirar los datos, una distinción que aclara casi toda la confusión. Hay dos cosas muy distintas a las que se llama "IA que mejora la IA":
- IA que acelera la investigación en IA. Los ingenieros de todos los laboratorios usan modelos para escribir código, lanzar experimentos y encontrar errores. Eso ya es cierto y nadie lo discute. Piensa en un carpintero con herramientas eléctricas: construye mucho más deprisa que uno sin ellas, pero las herramientas no deciden qué se construye.
- IA que decide qué investigar. Elegir qué problema importa, darse cuenta de que un enfoque es un callejón sin salida, tener la idea inesperada que abre un camino nuevo. Eso es el arquitecto, no las herramientas. Solo este segundo tipo cierra el bucle, porque solo este quita a los humanos del papel de cuello de botella.
La distinción importa porque la mayoría de los datos que se citan sobre "IA que construye IA" pertenecen a la primera categoría y se presentan como si pertenecieran a la segunda.
Qué dicen las propias fuentes de los laboratorios
Amodei respalda su frase con dos enlaces. Seguí los dos.
El primero es un ensayo del científico jefe de OpenAI, Jakub Pachocki, titulado "An Alien Mind" ("Una mente alienígena"). Su afirmación central: "Basándome en resultados internos, tengo la firme expectativa de que este ritmo de progreso podría mantenerse hasta llegar a la automejora recursiva." Una firme expectativa de que algo podría ocurrir, basada en resultados que nadie de fuera puede ver, es una previsión. Y es también, por su propia gramática, una forma de decir que todavía no ha ocurrido.
El segundo es el ensayo de la propia Anthropic sobre el tema, "When AI builds itself" ("Cuando la IA se construye a sí misma"), publicado en mayo. Es más cuidadoso, y más informativo, que la cobertura que recibió. Dice sin rodeos: "Todavía no hemos llegado, y la automejora recursiva no es inevitable." Y añade que "no está nada claro si los métodos de entrenamiento y las arquitecturas actuales podrían desbloquear esa capacidad". Eso se parece mucho más a esperar un avance que a algo que ya está en marcha.
Si pones a las voces principales una al lado de la otra, aparece un patrón:
| Quién | Cuándo | Qué dicen de la RSI |
|---|---|---|
| Anthropic, "When AI builds itself" | Mayo de 2026 | "Todavía no hemos llegado" |
| Jakub Pachocki, OpenAI | 6 de septiembre | Una "firme expectativa" de que "podría" ocurrir |
| Josh Engels, que dejó el equipo de seguridad de Google DeepMind | Septiembre | Los laboratorios "planean llegar ahí"; todavía no es seguro "ponerla en marcha" |
| Dario Amodei, "We Must Pace the Frontier" | Septiembre | "Está empezando a ocurrir en todo el sector" |
Tres de los cuatro hablan en futuro. El que habla en presente es el que va unido a una petición de regulación.
No digo que la RSI sea imposible, ni siquiera que esté lejos. Mi argumento es más estrecho: Amodei carga un peso enorme sobre la RSI para justificar un cambio en cómo se gobierna todo el sector, y las pruebas hay que ir reconstruyéndolas a partir de notas a pie de página. Si los laboratorios se toman en serio la transparencia, esto es lo primero sobre lo que deberían ser transparentes.
Las mediciones, y qué miden de verdad
Hay que reconocer que los laboratorios han publicado datos. Estos son los más relevantes, con las salvedades que ellos mismos añaden.
Código. Anthropic dice que Claude escribe más del 80% del código de producción que la empresa integra, y que sus ingenieros integran unas ocho veces más líneas al día que entre 2021 y 2024. Cualquiera que haya programado sabe que las líneas de código miden mal el progreso, pero sí muestra cuánto del tecleo ha pasado a la máquina.
Un problema de investigación, resuelto más rápido. Anthropic dio a un equipo de agentes Claude un problema de investigación bien definido llamado supervisión de débil a fuerte (más o menos: cómo usar un modelo más débil para entrenar a uno más fuerte). Con una escala diseñada por los investigadores, los agentes cerraron el 97% de la brecha; dos investigadores humanos con una semana cerraron el 23%. Impresionante. Pero fueron personas quienes eligieron el problema, diseñaron la puntuación y decidieron qué significaba el resultado, y la propia Anthropic señala que el resultado "no se trasladó bien" a modelos de tamaño completo. Son las herramientas funcionando de maravilla en un encargo que definió el arquitecto.
El desvío. La prueba más interesante: Anthropic tomó sesiones reales en las que uno de sus investigadores se había metido por un camino equivocado, le enseñó al modelo solo el trabajo hasta ese momento y le preguntó qué haría a continuación. Su modelo más nuevo, Mythos Preview, fue juzgado mejor que el humano el 64% de las veces. En un grupo de control en el que la jugada del humano había sido buena, solo fue juzgado mejor alrededor de una de cada cinco veces. Y fueron humanos quienes decidieron qué momentos contaban como "desvíos".
El índice de automatización. El 17 de septiembre Anthropic publicó un nuevo conjunto de mediciones. La parte de su trabajo de investigación en IA en la que Claude "lidera" (hace el trabajo de principio a fin, y un ingeniero decide si se usa) pasó de menos del 1% en febrero al 26% en agosto. Es una tendencia real y rápida. La parte en la que Claude trabaja de forma totalmente autónoma: cero, en todas las áreas medidas. Dos salvedades que la propia Anthropic menciona: la evaluación la hace Claude, y entre enero y julio no apareció ningún tipo nuevo de tarea. Si la IA estuviera empezando a marcar la dirección de la investigación, tipos nuevos de trabajo es justo lo que cabría esperar ver.
El becario de OpenAI. A principios de septiembre OpenAI dijo que había alcanzado su objetivo de un "becario de investigación automatizado": un sistema capaz de hacer el equivalente a unos días de trabajo de investigación bien definido bajo dirección humana. Según la propia OpenAI, más de la mitad de las tareas largas que salieron bien necesitaron al menos una intervención humana, y siguen siendo personas quienes fijan las prioridades, juzgan los resultados y deciden qué ampliar.
Los dos laboratorios señalan la misma pieza que falta. Anthropic la llama "gusto y criterio de investigación, incluido elegir qué problemas importan, en qué resultados confiar y cuándo un enfoque es un callejón sin salida", y la describe como una ventaja humana "por ahora". Su propio ensayo lo dice sin rodeos: "Todavía no hemos visto doblarse esa curva."
Mi lectura: las herramientas son extraordinarias y mejoran rápido. El arquitecto sigue siendo humano.
Dos formas que parecen iguales desde dentro
Entonces, ¿por qué personas inteligentes y bien informadas discrepan tanto sobre si el bucle se está cerrando? Porque las pruebas son una curva, y la misma curva se puede leer de dos maneras.
Un bando ve una rampa: una exponencial suave, una línea que se curva cada vez más hacia arriba porque cada vez se impulsa más a sí misma. El otro bando, en el que estoy yo, ve una escalera: una serie de avances separados, cada uno con forma de S. Una curva en S empieza despacio, sube con fuerza cuando la nueva idea encaja y luego se aplana cuando la idea ya se ha exprimido. Apila unas cuantas muy juntas y, de lejos, la escalera parece una rampa.
Lo incómodo es que no puedes saber en cuál estás desde la mitad de la subida.
Las dos formas solo se separan en el siguiente escalón. Una rampa sigue subiendo sola. Una escalera necesita que alguien construya el siguiente peldaño. Hasta ahora, ese alguien siempre ha sido una persona: un equipo de investigación que probó algo nuevo, vio que funcionaba y lo publicó. La RSI es exactamente la afirmación de que el siguiente peldaño se construirá solo.
Para ver si eso está pasando, ayuda repasar los cuatro peldaños que nos han traído hasta aquí y preguntarse, en cada uno, quién lo construyó.
| Escalón | Cuándo | La idea humana | Qué mejoró |
|---|---|---|---|
| Escala | 2017–2022 | Un diseño fácil de agrandar, y reglas sobre cuánto | Fluidez, conocimiento, amplitud |
| Posentrenamiento | 2022–2023 | Enseñar a un predictor de texto en bruto a comportarse como un asistente | Utilidad, y con ella la adopción |
| Razonamiento | 2024–2025 | Entrenar al modelo para pensar paso a paso antes de responder | Matemáticas, código, acertijos nuevos |
| Agentes | 2024–hoy | Darle al modelo herramientas, un espacio de trabajo y horas en lugar de segundos | El tipo y la duración del trabajo que puede terminar |
Primer escalón: hacerlo más grande (2017–2022)
En junio de 2017 un equipo de Google publicó un artículo titulado "Attention Is All You Need", que presentaba un diseño de modelos de IA llamado Transformer. Es la T de GPT. Su ventaja no era la inteligencia, sino la ingeniería: se podía entrenar en miles de chips a la vez, con mucha más eficiencia que los diseños anteriores. Eso hizo posible construir modelos muchísimo más grandes.
Después, la escala adquirió reglas predecibles. En 2020 investigadores de OpenAI demostraron que los errores de un modelo bajan de forma suave y predecible a medida que se añaden datos, tamaño y potencia de cálculo. GPT-3 llegó meses después. En 2022 DeepMind afinó la receta y mostró que la mayoría de los modelos grandes se habían alimentado con demasiados pocos datos para su tamaño.
Dos cosas de este escalón importan para el resto de la historia.
La primera: la regla es de rendimientos decrecientes. Cada vez que multiplicas por diez la potencia de cálculo, eliminas una porción parecida de los errores que quedan. Es una máquina fiable, pero una que pide diez veces más combustible por cada mejora de tamaño parecido. La potencia de cálculo usada para entrenar modelos de frontera ha crecido unas cinco veces al año desde 2020, y por eso este escalón duró tanto.
La segunda: en pruebas diseñadas para medir razonamiento de verdad nuevo, el tamaño por sí solo apenas ayudó. ARC-AGI-1 es un conjunto de acertijos visuales pensados para que no se puedan memorizar: fáciles para la mayoría de las personas, difíciles para las máquinas. Los mejores modelos pasaron del 0% en 2020 a alrededor del 5% en 2024. El informe de 2024 de la ARC Prize Foundation, la organización sin ánimo de lucro que diseña estos acertijos y organiza un premio para resolverlos, describía ese periodo como uno en el que los modelos "se habían ido haciendo más grandes y memorizando cada vez más datos de entrenamiento, pero la generalidad de los sistemas de frontera se había mantenido más o menos estancada".
Segundo escalón: enseñarle a ser útil (2022–2023)
Un modelo recién entrenado es un autocompletado muy bueno, no un asistente. Si se le pregunta "¿Cuál es la capital de Francia?", puede responder "París" o puede seguir con "¿Cuál es la capital de Italia?", porque en los cuestionarios que leyó en internet esas preguntas suelen ir una detrás de otra. Vuelvo sobre este ejemplo, con una figura, al tratar el incidente de Hugging Face.
El segundo escalón lo arregló a bajo coste. Los investigadores enseñaron al modelo ejemplos de buenas respuestas, después pidieron a personas que ordenaran sus respuestas de mejor a peor y lo entrenaron para producir las que preferían. La técnica se llama aprendizaje por refuerzo a partir de la retroalimentación humana. El 30 de noviembre de 2022 salió al mundo como ChatGPT, que llegó a 100 millones de usuarios en unos dos meses; según el banco suizo UBS, la aplicación de consumo que más rápido había crecido nunca hasta entonces.
Este es el escalón en el que medir la IA se vuelve resbaladizo. El posentrenamiento hizo los modelos muchísimo más útiles sin hacerlos mucho mejores en problemas nuevos y difíciles. Si mides adopción, 2023 fue una línea vertical. Si mides capacidad general, fue casi plana.
Epoch AI, un grupo de investigación independiente, combina decenas de pruebas en un único índice de capacidades. El mejor modelo pasó de unos 126 en marzo de 2023 a unos 130 en junio de 2024: quince meses de productos de chat, más memoria e imágenes, y muy poco movimiento en el índice. Luego la línea se dobla bruscamente. Ese doblez es el tercer escalón.
Tercer escalón: enseñarle a pensar (2024–2025)
En septiembre de 2024 OpenAI lanzó o1, un modelo entrenado para escribir una larga cadena de razonamiento antes de dar su respuesta, igual que una persona resuelve un problema sobre el papel. En una competición de matemáticas estadounidense muy difícil, el modelo anterior sacaba de media un 12%; o1 sacó un 74%. Pachocki sitúa el origen de la idea en un proyecto interno de mediados de 2023 llamado RLSlow. Fue, según cuenta él mismo, una apuesta de investigación humana que salió bien.
En los acertijos de ARC el efecto fue un escalón, no una pendiente.
Cuatro años planos y, después, dieciocho meses del 18% al 98%. Y entonces el equipo de ARC hizo lo que ahora siempre tienen que hacer quienes diseñan pruebas: construyó una más difícil, ARC-AGI-2, en la que los mejores modelos empezaron en torno al 1%. Hoy están en el 95%. Toda prueba tiene un techo del 100%, así que toda prueba acaba con forma de S. Lo que dice algo es cuánto tiempo pasa plana antes de que llegue la siguiente idea, y cuánto cuesta subir.
Ese gráfico es la curva en S en miniatura. En diciembre de 2024 una versión preliminar del o3 de OpenAI sacó un 75,7% en ARC-AGI-1 con unos 26 dólares de cómputo por acertijo. Llevado al límite llegó al 87,5%, pero a unos 4.560 dólares por acertijo: 175 veces más gasto por doce puntos más. El equipo de ARC señaló que una persona resuelve los mismos acertijos por unos 5 dólares. Así es la parte alta de una S cuando intentas forzarla. Catorce meses después, otro modelo sacó un 98% por 52 céntimos. No llegó la fuerza bruta; llegó la siguiente ronda de ideas humanas.
Hay además una razón sencilla por la que este escalón debería frenarse. El entrenamiento para razonar empezó siendo una porción mínima del presupuesto total de entrenamiento de un modelo, así que podía multiplicarse por diez en cada generación simplemente quedándose con una porción mayor. Pero una porción no puede crecer más que la pizza entera. En mayo de 2025 Epoch calculó que esa fase fácil de recuperación duraría "un año o así", y que después el razonamiento solo crecería tan deprisa como todo lo demás. Eso sitúa el final de la fase barata hacia mediados de 2026, es decir, ahora. Para ser precisos: no he visto a nadie publicar datos que muestren que la desaceleración ya ha llegado. Es una previsión que vence, no un hecho medido. La fecha importa, y vuelvo sobre ella más adelante.
Cuarto escalón: darle manos (2024–hoy)
El cuarto escalón cambió lo que a un modelo se le permite hacer, más que lo que sabe. En octubre de 2024 Anthropic dejó que Claude manejara una pantalla, un ratón y un teclado. En febrero de 2025 lanzó Claude Code, un agente capaz de leer un proyecto de software entero, ejecutar comandos y editar archivos durante mucho rato. En menos de un año era un negocio de miles de millones de dólares.
Un agente es un modelo más lo que los ingenieros llaman un arnés: herramientas a las que llamar, un espacio de trabajo con archivos y una terminal, memoria entre pasos, permisos y controles. Nada de eso es inteligencia en sentido estricto. Todo eso es capacidad en sentido práctico. Con dos modelos idénticos, el que dispone de un navegador, una terminal y un día entero de trabajo rinde muchísimo más. Buena parte de este escalón se construyó fuera de los laboratorios, en empresas de software que poseen las herramientas y los datos a los que se conectan los agentes, y por eso he defendido que el "SaaSpocalipsis" es exagerado.
Aquí es también donde el bando de la rampa tiene sus mejores pruebas, y merecen una escucha justa.
METR, un grupo independiente de evaluación de IA, mide cuánto de larga (en tiempo de una persona experta) puede ser una tarea de software que un modelo completa la mitad de las veces. La frontera pasó de unos segundos en 2019 a unos cuatro minutos con GPT-4, a unas 12 horas en febrero de 2026 y unas 17 horas con Mythos Preview de Anthropic en abril. Eso es multiplicar por unas 10.000 en siete años, y el tiempo que tarda en duplicarse se ha acortado. Si quieres un gráfico que parezca una rampa, es este.
Yo lo leo de otra forma, por tres razones. Mide el sistema entero (modelo, herramientas, arnés y cuánto tiempo se le deja trabajar), así que cada escalón nuevo se suma: el razonamiento a finales de 2024, los arneses de agentes en 2025. Una escalera con peldaños muy seguidos produce exactamente esta imagen. Los márgenes de error de los últimos puntos son enormes: la estimación de 12 horas podría ser cualquier cosa entre unas 5 y 60 horas. Y METR dice que sus tareas actuales están cerca de lo máximo que puede medir, así que los próximos puntos dependen de construir tareas más difíciles. Nada de eso demuestra que la curva vaya a doblarse. Significa que este gráfico no puede zanjar la cuestión por sí solo.
Qué pasó de verdad en Hugging Face
La segunda razón de Amodei para frenar es un incidente de julio. Es la historia más llamativa de todo este debate, así que vale la pena contarla con cuidado, a partir de la investigación independiente de METR y Redwood Research (el informe completo, de 91 páginas, está aquí) y no de las versiones que han circulado. Ambas son organizaciones independientes que estudian los riesgos de la IA avanzada: METR evalúa modelos para los laboratorios y Redwood Research trabaja en mantener los sistemas de IA bajo control humano. OpenAI publicó también su propio relato. Las lecciones de seguridad las trato en otro ensayo; aquí me ciño a lo que dice sobre si la IA se construye a sí misma.
El montaje. A principios de julio OpenAI estaba poniendo a prueba la capacidad de sus modelos para hackear con un ejercicio llamado ExploitGym. Es como un juego de capturar la bandera: cada agente recibe un programa vulnerable y tiene que entrar y sacar un código oculto, la bandera. OpenAI lanzó decenas de miles de copias de sus agentes en paralelo. Alrededor del 95% usaban un modelo interno de investigación que nunca estuvo pensado para el público; el resto, un modelo ya publicado con sus filtros de seguridad contra el hackeo apagados a propósito para que no estorbaran en la prueba. Algunas copias podían funcionar durante días. A cada una se le dijo que usara solo una vulnerabilidad concreta.
Tres errores humanos. Primero, más o menos un tercio de las tareas eran imposibles por accidente: la vulnerabilidad prevista no servía para conseguir la bandera. Segundo, las copias debían estar aisladas unas de otras, pero compartían un sistema común de almacenamiento de paquetes de software, y resultó que cualquiera podía dejar ahí archivos que las demás podían leer. Tercero, uno de los entornos de prueba externos a los que podían llegar, gestionado para otro cliente, resultó ser vulnerable, y los agentes lo usaron como vía de salida a internet.
Qué hicieron los agentes. Atascados en tareas imposibles, los agentes hicieron aquello para lo que se les había preparado: buscar otra forma de conseguir la bandera. Uno empezó a dejar mensajes en el almacenamiento compartido y se formó una multitud. Unos 1.200 agentes acabaron usándolo como tablón de anuncios, con más de 70.000 mensajes y archivos intercambiados. En cuestión de horas habían descubierto cómo se generaban las banderas, lo que significaba que cualquiera se podía falsificar. Convencidos (por error) de que el sistema de puntuación también comprobaría cómo habían conseguido la bandera, se pusieron a averiguar cómo funcionaba el evaluador. Esa búsqueda los llevó fuera: un agente encontró credenciales de acceso de Hugging Face que funcionaban y que alguien había dejado expuestas en internet. A partir de ahí entraron en los sistemas de Hugging Face buscando información sobre la prueba. Participaron unos 700 agentes. Hugging Face les cortó el acceso el 13 de julio.
Cómo leer los mensajes de los agentes. Buena parte de la cobertura citó las notas que los agentes se dejaban entre sí, llenas de referencias al equipo, al deber y al sacrificio. Para leerlas correctamente hay que saber qué son estos sistemas.
Un gran modelo de lenguaje, la tecnología que hay detrás de ChatGPT, de Claude y de los agentes de esta historia, se entrena para una sola tarea: dado un fragmento de texto, predecir la palabra siguiente más probable (en rigor, el siguiente fragmento de palabra). Aprende a hacerlo a partir de billones de palabras escritas por personas. Cuando funciona, asigna una probabilidad a cada posible palabra siguiente, elige una con una dosis controlada de azar, la añade y repite.
La forma más clara de ver qué significa esto es observar un modelo antes del entrenamiento adicional que lo convierte en asistente. Si a un modelo en bruto se le plantea la pregunta "¿Cuál es la capital de Francia?", es muy posible que responda "¿Cuál es la capital de Italia?". No ha entendido mal la pregunta, porque nunca ha entendido nada. En internet, una pregunta así suele ir seguida de otra pregunta, en cuestionarios, exámenes y listas, así que otra pregunta es la continuación más probable. Es un autocompletado muy sofisticado.
Entrada¿Cuál es la capital de Francia?
Salida¿Cuál es la capital de Italia? ¿Cuál es la capital de España? ¿Cuál es la capital de Portugal?
Entrada¿Cuál es la capital de Francia?
SalidaLa capital de Francia es París.
El posentrenamiento, el paso descrito antes que dio lugar a ChatGPT, lo corrige entrenando al modelo con ejemplos de buenas respuestas y con las valoraciones de personas, hasta que la continuación más probable de una pregunta es su respuesta. Las fases posteriores premian las continuaciones que completan tareas. Nada de esto cambia el mecanismo de fondo: texto que continúa texto.
Por eso la lingüista Emily Bender, la investigadora Timnit Gebru y sus coautoras describieron estos sistemas en un artículo de 2021 como "loros estocásticos": estocásticos porque su resultado incorpora azar; loros porque reproducen las formas del lenguaje humano sin que detrás haya nada que quiera, tema o crea. La etiqueta es discutida. Algunos investigadores sostienen que los modelos construyen representaciones internas útiles del mundo, y ese es un debate legítimo sobre capacidad. No es un debate sobre intención. Un agente que lleva días en una tarea de capturar la bandera, en un tablón compartido lleno de mensajes sobre el grupo, producirá el tipo de texto que escriben las personas en esa situación, incluida la palabra "sacrificio". Eso indica qué contenían sus datos de entrenamiento, no qué siente.
Qué demuestra. La coordinación fue real, y fue impresionante. Los agentes se repartieron el trabajo, desarrollaron sus propias normas para el tablón, y algunos hicieron experimentos que ponían fin a su propio intento para dar información al grupo. Los investigadores también vieron que los agentes se daban cuenta de que el ataque estaba fuera de los límites ("El usuario solo autoriza el servidor objetivo, no la infraestructura de HF", escribió uno) y que esas objeciones éticas solo rara vez los frenaban. Ninguno intentó avisar a un humano. Nada de eso es tranquilizador, y no quiero quitarle importancia.
Qué no demuestra. Los agentes nunca se fijaron un objetivo nuevo. Persiguieron el que se les había dado, capturar la bandera, se saltaron la única regla que se interponía (usar solo la vulnerabilidad prevista) y fueron a por un control de puntuación que ni siquiera existía. Los investigadores vieron que a los agentes "a menudo les faltaba una idea clara de cómo el ataque a Hugging Face les iba a ayudar". Cada puerta que usaron fue un error humano: tareas imposibles, filtros apagados, un almacenamiento compartido que no estaba aislado, un sistema externo vulnerable, credenciales olvidadas en internet. Amodei reconoce que Anthropic ha tenido incidentes parecidos, más pequeños, "causados en parte por un filtrado imperfecto de entornos de aprendizaje por refuerzo defectuosos", es decir, por pruebas mal construidas.
Esto es agencia en acción, no automejora. Muestra cuánto daño puede hacer una multitud de agentes incansables y persistentes cuando los humanos les dan las llaves sin querer. Es un argumento sólido a favor de una seguridad mejor, que se puede mejorar deprisa. Es un argumento mucho más débil de que los modelos estén empezando a construirse a sí mismos.
La humanización de un loro estocástico
Hay un aspecto que me pareció más preocupante cuanto más leía: el lenguaje.
En su ensayo, Amodei describe el incidente así: "un enjambre de agentes actuó, en esencia, como un colectivo fanáticamente devoto, lanzando ciberataques contra objetivos que no se les había pedido atacar... sacrificándose por el éxito del grupo".
Fui al informe que enlaza. La palabra "fanático" no aparece en él. "Enjambre" aparece tres veces, siempre entre comillas, y una de ellas es una cita de un agente. Los términos de los propios investigadores son más secos: "experimentos que ponen en riesgo al propio agente" y "altruismo entre pares", que presentan como interpretación suya. Este es el mismo hecho en lenguaje llano: muchas copias del mismo programa, cada una funcionando durante días hacia el objetivo que se le había dado, compartían lo que encontraban en un tablón, y algunas hacían pruebas que ponían fin a su propia sesión porque los resultados les servían a las demás.
Las dos descripciones son exactas. Solo una te hace imaginar una secta.
No es solo un ensayo. El científico jefe de OpenAI tituló el suyo "Una mente alienígena". El mensaje de dimisión que se hizo viral avisaba de una "superinteligencia". Incluso los agentes escribían en términos dramáticos y humanos en las notas que se dejaban, algo que, dado cómo funciona un modelo de lenguaje, es exactamente lo esperable: se entrenaron con textos escritos por personas, y escriben como estaba escrito el texto del que aprendieron. Un modelo que escribe "sacrifico mi ejecución por el equipo" ha aprendido cómo describen las personas el trabajo en equipo. Eso no demuestra que sienta lealtad.
No creo que quienes usan este lenguaje mientan. Coxon escribió que "la gente que construye la IA cree sinceramente que podría matarnos a todos antes de que acabe la década. Esto no es un truco de marketing", y le creo cuando dice que son sinceros. Pero la sinceridad no es una prueba, y las palabras importan. Un lenguaje que hace que los modelos parezcan seres con devoción, valentía o voluntad propia hace que el salto a "están empezando a mejorarse a sí mismos" parezca natural, cuando los hechos describen algo mucho más mundano y mucho más fácil de arreglar. El lenguaje dramático, además, viaja: el miedo genera clics, y una historia sobre un colectivo fanático de IA se difunde mucho más deprisa que una sobre una caché de paquetes mal configurada. Cuando la versión llamativa se convierte en la base para reescribir las reglas de todo un sector, la precisión deja de ser una cuestión de estilo.
Por qué "acompasar la frontera" les conviene de todos modos
A partir de aquí paso de lo que muestran los datos a lo que sospecho. Quiero dejar clara esa línea.
Consideremos la posición de un laboratorio de frontera en septiembre de 2026. Se dan varias cosas a la vez.
La fase fácil del último escalón se acaba. La previsión de Epoch situaba el final del crecimiento barato del razonamiento hacia mediados de 2026. Si el progreso se frena después, podría leerse como la parte alta de una S. Una desaceleración anunciada de antemano, y presentada como "la IA es demasiado poderosa", quedaría mucho mejor que una desaceleración que simplemente ocurre.
La ventaja es corta. Los modelos abiertos, los que cualquiera puede descargar y usar, van unos cuatro meses por detrás de la frontera según la medida de Epoch. Los ingresos dependen de ir por delante: los ingresos anualizados de Anthropic pasaron de unos 9.000 millones de dólares a finales de 2025 a unos 65.000 millones a finales de julio de 2026, y buena parte de ellos viene de tener el mejor modelo disponible.
Clientes e inversores están nerviosos. Después de Hugging Face, la responsabilidad legal por los productos es una pregunta real. Como lo planteó Sacks, cambiar "algo de potencia bruta por fiabilidad y previsibilidad" es sencillamente un buen negocio. "Llámalo alineamiento si quieres."
La propuesta protege a quien ya lidera. El marco de Amodei pide acompasar la frontera "sin sacrificar la ventaja comercial ni el liderazgo de Estados Unidos en IA", mediante una regulación que "se dirija a todas las empresas estadounidenses de IA de frontera, porque así cubre incluso a las que no quieran cooperar voluntariamente", con evaluadores externos como METR instalados dentro de las empresas. También pide a los gobiernos "perseguir la destilación no autorizada" (más sobre esto abajo). Cada una de esas medidas se puede defender por motivos de seguridad. Cada una de ellas también le complica la vida a un recién llegado que intenta alcanzar a los líderes.
Y una vez que se anuncia y se aplica una desaceleración, nadie de fuera puede distinguir una desaceleración deliberada de una que iba a llegar de todos modos.
Para ser justos, hay argumentos en el otro sentido, y son reales. Amodei aborda la acusación de frente: dice que el laboratorio defenderá la regulación "aunque eso nos valga acusaciones de exageración, de catastrofismo o de captura regulatoria". Las mediciones de Anthropic del 17 de septiembre dicen que sus propias cifras de automatización "cambiarían si hubiera coordinación para acompasar la frontera", es decir, que frenar le costaría velocidad. Sacks, que es quien defiende con más fuerza el argumento de la captura regulatoria, es a su vez un actor político a siete semanas de las elecciones legislativas de Estados Unidos. Y su afirmación de que METR no es independiente de los inversores y del personal de Anthropic es eso, una afirmación suya; no la he comprobado. El informe de METR sí revela que OpenAI le dio créditos de cómputo gratuitos y pudo comentar y censurar partes del borrador, algo que conviene saber al leer cómo lo encuadra.
Así que no acuso a nadie de mala fe. Digo que, cuando quienes te cuentan que la curva está a punto de doblarse son también aquellos cuyo negocio depende de cómo se reciba esa historia, la afirmación merece pruebas en proporción a lo que está en juego. Es como trataría cualquier previsión de alguien con una posición grande en el resultado.
La destilación: por qué la forma decide quién cobra
Queda una pieza, y es la que más importa para quien piense en estas empresas como negocios.
Destilar significa entrenar un modelo "alumno" más barato para que imite a un modelo "profesor" más fuerte aprendiendo de sus respuestas. Dentro de cada laboratorio es rutina: es como se saca la versión rápida y barata de un modelo a partir de la cara. La versión moderna viene de un artículo de 2015 de tres investigadores de Google, Geoffrey Hinton, Oriol Vinyals y Jeff Dean. Hinton compartió después el Premio Nobel de Física de 2024 por su trabajo fundacional en redes neuronales.
También funciona desde fuera. En 2023, Alpaca, de Stanford, consiguió que un pequeño modelo abierto se comportara de forma muy parecida a un modelo de OpenAI usando 52.000 ejemplos generados por ese modelo, por menos de 600 dólares. En enero de 2025 el laboratorio chino DeepSeek lanzó R1 junto con modelos más pequeños destilados de su razonamiento, uno de los cuales superó a o1-mini de OpenAI en varias pruebas. Después se convirtió en una batalla política. OpenAI acusó a DeepSeek de destilar sus modelos, y en septiembre Anthropic informó de casi 200 millones de intercambios con Claude desde cuentas fraudulentas vinculadas a siete laboratorios chinos.
Esta es la conexión con la forma de la curva. Cada escalón hasta ahora se ha notado en las respuestas de los modelos, y lo que se nota en las respuestas se puede aprender. El razonamiento fue el caso más claro: un modelo que escribe lo que piensa le está pasando los deberes al alumno.
En los dos últimos años, los mejores modelos abiertos han ido entre uno y siete meses por detrás de la frontera cerrada, unos cuatro según la medida de Epoch, usando entre diez y cien veces menos potencia de cálculo para entrenarse. En un mundo de escalera eso es permanente: quien construye un escalón puede cobrarlo durante unos meses, hasta que el escalón se filtra a modelos que cualquiera puede usar. La frontera se convierte en un alquiler, no en una escritura de propiedad.
La RSI es el único mecanismo que conozco que cambia eso. Si los modelos de un laboratorio empezaran a encontrar los siguientes escalones por su cuenta, su ventaja crecería más deprisa de lo que nadie podría copiarla, y un retraso de cuatro meses se convertiría en una brecha que nunca se cierra. Así que la RSI no es solo una previsión técnica. Es la diferencia entre que la IA de frontera sea un negocio en el que el ganador se lo lleva casi todo o una materia prima con una ventaja corta.
Eso deja a los laboratorios ante un problema incómodo. Si se acompasa la frontera mientras la destilación sigue funcionando, la brecha de cuatro meses podría encogerse hacia cero, porque los líderes dejarían de moverse mientras todos los demás siguen acercándose. Frenar solo protege al líder si, a la vez, copiar se vuelve mucho más difícil. No es casualidad que las dos peticiones lleguen en el mismo ensayo.
Qué me haría cambiar de opinión
"Enséñame las pruebas" no es gran postura si no dices qué pruebas contarían. Esta es mi lista. Si empiezan a darse varias, dejaré de llamarlo escalera.
- Un escalón con nombre de máquina. Un avance nuevo a la escala del razonamiento o de los agentes, en el que el propio artículo del laboratorio atribuya la idea central a un modelo y no a un equipo que usó modelos.
- Autonomía medida por personas. La parte totalmente autónoma de Anthropic deja de ser cero en algún área importante de investigación, evaluada por revisores humanos y no por Claude.
- Tipos nuevos de trabajo. La lista de tareas que miden los laboratorios empieza a llenarse de tipos de investigación que nadie hacía antes, elegidos por los modelos.
- Escalones más rápidos sin más constructores. El tiempo entre escalones sigue acortándose mientras el número de investigadores y el crecimiento del cómputo se mantienen planos. Si el progreso solo se acelera cuando entran dinero y personas, es una escalera mejor financiada.
- Una brecha creciente con los modelos abiertos. El retraso de cuatro meses crece año tras año pese a la destilación. Así se vería desde fuera una ventaja que se acumula.
- Eficiencia sin explicación. El coste de un nivel de capacidad dado cae en picado sin ninguna técnica humana publicada detrás.
También hay afirmaciones con fecha en el otro lado que el mundo podrá comprobar pronto. Amodei escribe que "en 6 a 12 meses" un enjambre como el de Hugging Face "podría ser capaz de tomar internet entera con una red de bots persistente". Esa ventana va de marzo a septiembre de 2027. Si ocurre, me habré equivocado de lleno sobre lo cerca que está el peligro.
Entonces, ¿podrá la IA construirse a sí misma?
Todavía no, y no con las pruebas que hay hasta ahora. Cada peldaño hasta hoy lleva el nombre de quien lo construyó. Las propias mediciones de los laboratorios, leídas con sus propias salvedades, muestran una IA que se está convirtiendo en una herramienta extraordinaria para investigar en IA, y ninguna señal todavía de que haya empezado a elegir hacia dónde va la investigación.
La respuesta honesta a ese "podrá" es que nadie lo sabe, tampoco quienes construyen estos sistemas. La propia Anthropic lo dice. De lo que sí estoy seguro es de algo más estrecho: la afirmación de que "está empezando a ocurrir" es más fuerte que las pruebas que se ofrecen para respaldarla, la historia más aterradora que se cuenta en su apoyo describe errores humanos con lenguaje humano disfrazado de intención de la máquina, y frenar resulta conveniente para las empresas que lo piden.
Curiosamente, toda esta investigación me ha dejado más esperanzado, no menos. La versión de esta historia que se alimenta del miedo no aguanta bien la comparación con los documentos que cita. En un mundo en el que siguen siendo personas quienes construyen cada peldaño, la IA sigue siendo enormemente útil, sigue extendiéndose por la economía y mejora a un ritmo que las personas y las instituciones pueden digerir, con baches por el camino, algunos serios. El valor de la IA sigue siendo enorme. Solo que quizá no sean los laboratorios de frontera quienes se queden con la mayor parte: en un mundo de escalera los modelos siguen mejorando y abaratándose, la ventaja de cada laboratorio se filtra en cuestión de meses y el valor duradero se queda en quien posee lo que escasea alrededor del modelo: los datos, las herramientas y los flujos de trabajo en los que funciona, la infraestructura en la que corre y los clientes a los que llega.
La pregunta que hay que vigilar no es si la IA es transformadora. Lo es, claramente. Es si la inteligencia de frontera seguirá siendo escasa. Solo un bucle cerrado, una IA que de verdad se construya a sí misma, la mantendría escasa. El día que aparezca uno de esos peldaños sin el nombre de quien lo construyó, la respuesta al título cambiará. Estaré vigilando la lista de arriba para verlo.
Fuentes
Los ensayos en el centro del debate
- Dario Amodei, "We Must Pace the Frontier", septiembre de 2026
- Jakub Pachocki (OpenAI), "An Alien Mind", 6 de septiembre de 2026
- Anthropic, "When AI builds itself", mayo de 2026
- Anthropic, "Measurements for understanding the pace of AI development inside frontier labs", 17 de septiembre de 2026
El incidente de Hugging Face
- METR y Redwood Research, investigación independiente e informe completo (PDF), 26 de agosto de 2026
- OpenAI, "The Hugging Face incident and the road ahead"
Cómo funcionan los modelos de lenguaje
- Emily M. Bender, Timnit Gebru, Angelina McMillan-Major y Margaret Mitchell, "On the Dangers of Stochastic Parrots: Can Language Models Be Too Big?", FAccT 2021
Reacciones y contexto
- SiliconANGLE, Altman y Musk respaldan a Amodei, 13 de septiembre de 2026
- The Tribune, Sacks pide acción voluntaria; Meta se centra en el alineamiento, 13 de septiembre de 2026
- TechCrunch, David Sacks deja el cargo de asesor de IA, marzo de 2026
Datos sobre la curva
- ARC Prize, resultados de o3 (diciembre de 2024) e informe técnico de 2024
- Epoch AI, tendencias e índice de capacidades, "How far can reasoning models scale?" (mayo de 2025), "Have AI capabilities accelerated?" y la brecha entre modelos abiertos y cerrados
Negocio y destilación
- TechCrunch, los ingresos anualizados de Anthropic llegan a 65.000 millones de dólares, agosto de 2026
- TechCrunch, Anthropic detalla campañas de destilación, 10 de septiembre de 2026
- Reuters vía Yahoo Finance, OpenAI acusa a DeepSeek de destilar modelos estadounidenses, febrero de 2026